
ANSWER
【結論】
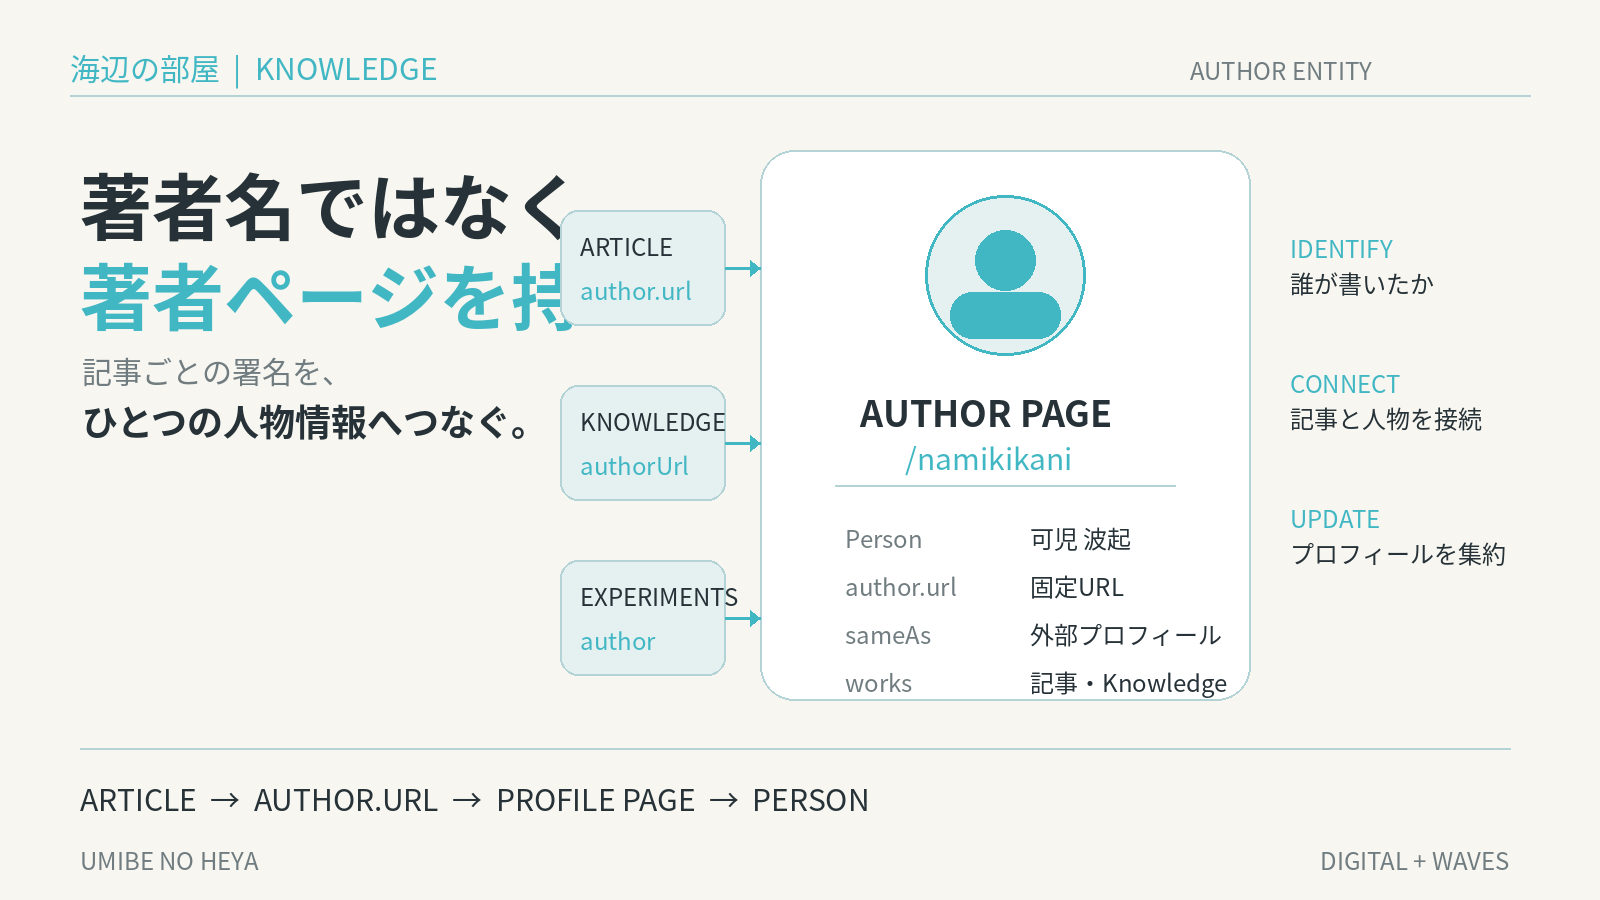
AI時代に著者ページを独立させる理由は、記事ごとの著者名を、同じ人物を一意に示す固定URLへ集約できるからです。著者プロフィール、専門領域、実績、外部プロフィール、記事一覧を1ページにまとめ、各記事のauthor.urlから同じページを参照すると、人間にも検索システムにも「誰が書いたか」を伝えやすくなります。ただし、著者ページを作るだけで検索順位やAI引用が上がる保証はありません。
Explanation
【詳しく解説】
著者名だけでは、「誰なのか」までは伝わらない
記事の末尾に著者名を書くだけでも、人間には「誰が書いた記事か」は分かります。
しかし、同じ名前の人がいる場合や、別の記事・別ページでも同じ人物が登場する場合、名前だけではサイト全体で一貫した識別子になりません。
そこで著者本人を説明する独立ページを1つ作り、記事側から常にそのURLを参照します。
著者ページは、単なる自己紹介ではなく、サイト内で「この人物とは誰か」をまとめる固定の参照先になります。
author.urlで、記事と人物をつなぐ
GoogleのArticle構造化データでは、author.urlとして「記事の著者を一意に識別するウェブページ」へのリンクを指定できます。
そのリンク先は、著者のSNS、Aboutページ、略歴ページなどでも構いませんが、サイト内部のプロフィールページを使う場合、GoogleはProfilePage構造化データで著者をマークアップすることを推奨しています。
つまり、各記事の著者名をバラバラに扱うのではなく、同じ著者ページへつなぐ構造を持たせられます。
著者ページは「一人の人物」を中心にする
GoogleのProfilePageガイドラインでは、ページの主役は、そのサイトに関係する単一の人物または組織であることが求められています。
ニュースサイトの著者ページ、ブログのAbout Me、企業サイトの従業員ページなどは有効な例として挙げられています。
著者ページに会社紹介、サービス説明、商品案内などを詰め込みすぎるより、「この人物は誰か」を中心にした方が役割が明確になります。
プロフィール情報を、記事ごとに繰り返さない
著者の経歴や専門領域を、すべての記事へ長く書く必要はありません。
記事には名前と短い肩書きを置き、詳しいプロフィールは独立ページへ集約できます。
経歴が変わったときも、著者ページを更新すればよく、何十本もの記事本文を修正する必要がありません。
これはSEO以前に、情報を重複させず一か所で管理するための設計として有効です。
Person情報を一か所へ集約する
ProfilePageでは、対象となるPersonまたはOrganizationに、name、description、image、identifier、sameAsなどの情報を持たせられます。
sameAsを使えば、本人の外部プロフィールやホームページなど、同じ人物を示す別URLも関連づけられます。
重要なのは、プロパティを増やすこと自体ではなく、同じ人物について複数ページで矛盾した説明をしないことです。
Blog・Knowledge・Experimentsから同じ人物へ戻る
海辺の部屋では、BlogだけでなくKnowledgeやExperimentsにも著者情報があります。
それぞれのコンテンツごとに別プロフィールを書くのではなく、authorUrlを共通の著者ページへ統一すると、コンテンツの種類が違っても同じ人物へ戻れます。
この構造は、サイト内で情報レイヤーが増えたときほど効きます。
著者名・クリック先・末尾リンク・構造化データを別々に確かめる
著者名を正しく表示できても、そこから公式の人物ページへ進めるとは限りません。また、人が見るリンクと、検索エンジン向けに記述する著者情報は別々に設定される場合があります。人物ページを作った後は、同じ記事の4か所を一組で確かめると、残っている作業が分かります。
「海辺の部屋」で著者情報を整理した過去の会話では、記事上部の名前が可児波起でも、クリック先はWixの会員プロフィールだった、とChatGPTが報告しています。本文末の人物ページへのリンクと、検索エンジン向けの著者情報は、その後の別工程として扱われていました。
2026年10月1日の確認例:原会話にURLが残る復興希望ソング「幸せの歌」の記事をクラウドブラウザで開き、次の4か所を同じ確認作業で調べました。
① 記事上部の名前:「可児波起」と表示されていました。
② 上部の名前を押した先:実際に開いた先は /members-area/7372/profile の会員プロフィールで、公式人物ページ /namikikani とは別でした。
③ 本文末の人物案内:「可児波起のプロフィール・経歴・活動実績を見る」を押すと /namikikani が開きました。
④ 検索エンジン向けの著者情報:公開ページに埋め込まれた構造化データ(JSON-LD)では、記事を表すBlogPostingが1本あり、author.nameは「可児波起」、author.urlは /namikikani、人物の識別子author.@idは /namikikani#personでした。
この1記事では、上部の名前から直接開く先は会員プロフィールのままですが、本文末の案内と構造化データは公式人物ページにつながっていました。「著者名を直した」だけの完了報告では、この違いが伝わりません。目的が公式人物ページへ案内することなら、どの入口でそれを実現できたかまで記録します。
同じ会話の後段には、当時の構造化データでは著者名とURLがなかったという別の報告もあります。しかし今回の公開ページには両方がありました。過去報告と現在の1記事の確認を区別し、いつ・どの操作で変わったかや、全ブログが同じ状態かまでは断定しません。
自分のサイトで使うときも、代表記事のURL、確認日時、4か所それぞれの値と到達先を残します。別の表示名や別人の著者記事へ変更を広げる前には、実際の執筆者を確認してください。保存と公開の違いは、外部サービス操作の確認段階で整理しています。
AI時代でも、やることは「人を明確にする」こと
AI検索や生成AIを意識すると、特殊な「AI向けプロフィール」を作りたくなります。
しかし、著者ページでまず必要なのは、人間が読んでも分かるプロフィール、専門領域、実績、関連コンテンツ、外部プロフィールです。
そのうえで、記事から同じauthor.urlを参照し、構造化データでも同じ人物を表します。
Google公式資料は、著者を一意に識別するURLやProfilePageの利用を案内していますが、それ自体が検索順位やAI回答への引用を保証するものではありません。
著者ページに置く情報
- 名前:サイト内で一貫した表記
- プロフィール:何をしている人物か
- 専門領域:どの分野について書いているか
- 実績:確認できる事実だけを掲載
- 関連コンテンツ:Blog・Knowledge・Experimentsなど
- 外部プロフィール:必要に応じてsameAsで関連づける
著者ページは、権威を大きく見せるためのページではありません。「この内容を書いた人物を、後から確かめられるページ」と考えると設計しやすくなります。
このKnowledgeの関連知識
サイト構造の前提: 著者ページは、Blog・Knowledge・Experiments・Sourcesを役割別に分けた情報資産構造の中で機能する。
Blog・Knowledge・Experiments・Sourcesを分ける理由
人物情報の根拠をつなぐ: Web上のPerson情報も、抽象的な自己紹介だけでなく、実績や具体的Evidenceへ辿れる構造にする。
人物像は「性格の要約」ではなく、具体的な会話とEvidenceで書く
現在地: WEB & CMS → 情報資産・サイト構造設計
EVIDENCE
【根拠・検証】
海辺の部屋での実装
海辺の部屋では、著者ページを https://www.umibe.art/namikikani として独立させています。
KnowledgeコレクションにはauthorとauthorUrlを別フィールドで持たせ、2026年9月22日時点で作成済みのKnowledge 11件は、著者「可児 波起」と同じauthorUrlへ統一しています。
著者ページ側では、ページ固有のPerson Entityを持たせ、記事側から同じ人物へ戻れる構造にしています。
この運用により、新しいKnowledgeを増やすたびに長い著者紹介を書き直す必要がなく、プロフィール情報は独立ページ側で更新できます。
Google公式仕様との照合
GoogleのArticle構造化データでは、author.urlを「記事の著者を一意に識別するウェブページへのリンク」と説明し、内部プロフィールページの場合はProfilePage構造化データの利用を推奨しています。
ProfilePageのガイドラインでも、ニュースサイトの著者ページ、ブログの自己紹介ページ、企業の従業員ページなどが有効例として示されています。
したがって、独立した著者ページを持つことは、少なくとも「記事と著者を同じURLで結び、人物情報を明確にする」というGoogle公式の構造と整合します。
2026年10月1日追記:著者情報の4か所を確認
対象は「東日本大震災復興希望ソング『幸せの歌』|可児波起・STAND WAVEの復興支援記録」1記事。クラウドブラウザの画面とリンクの実クリックで、上部著者名が可児波起、上部リンクの到達先が /members-area/7372/profile、末尾リンクの到達先が /namikikani であることを確認しました。同じ公開ページのJSON-LDにはBlogPostingが1本あり、author.name・author.url・author.@idは可児波起の公式人物ページを示していました。
過去の非公開会話には、上部リンクの行き先と構造化データの著者情報を別に調べたChatGPTの報告が残っています。今回の確認は当時のAPI操作、変更時点、全記事への適用、検索順位やAI引用の効果を証明するものではありません。
SOURCES
【情報源】
OFFICIAL SOURCE
Google公式:記事(Article)の構造化データ ↗
OFFICIAL SOURCE
Google公式:プロフィール ページ(ProfilePage)の構造化データ ↗
今回確認した公開記事
復興希望ソング「幸せの歌」。確認日時:2026年10月1日02:54〜02:55 UTC(日本時間11:54〜11:55)。表示名、2つの著者リンクの到達先、公開JSON-LDを確認しました。
非公開一次記録|著者接続を整えた会話
「権威性ページ作成」の著者工程3・4・6・8。2026年9月30日〜10月1日保存の原文を再読。古い作業報告と今回の公開ページの測定を分けています。
Author
【著者】
可児波起
マーケティングデザイナー / DXコンサルタント / 音楽家
次に読む
サイト構造の前提
Blog・Knowledge・Experiments・Sourcesを分ける理由
著者ページは、Blog・Knowledge・Experiments・Sourcesを役割別に分けた情報資産構造の中で機能する。
人物情報の根拠をつなぐ
人物像は「性格の要約」ではなく、具体的な会話とEvidenceで書く
Web上のPerson情報も、抽象的な自己紹介だけでなく、実績や具体的Evidenceへ辿れる構造にする。 この記事では、AIに人物像を共有するとき、「多面的な人」「本質を見る人」のような抽象的な性格説明だけを置くと、後からその人物評の根拠を追いにくくなります。可児 波起が国際ニュースやSNS資料をChatGPTと読み解き、背景・構造・自身の見解を整理した「世界情勢」プロジェクトでは、人物像をまとめる際に、可児 波起が「このプロジェクトのみ」「具体的な会話内容を書いて分析」と範囲と根拠を指定しました。
このテーマをもっと見る
CMSとBlogの役割、著者ページ、URL固定、知識資産構造を扱う。
上位カテゴリ
ChatGPTとWix・CMS・APIをつなぎ、壊れにくく続けられるWeb運用へ落とし込む。
すべてのテーマから探したい場合は、Knowledge一覧へ戻る。