
ANSWER
【結論】
生成AIは、失敗した画像や文章、選考結果などに対して、筋の通った説明や原因候補を作れます。しかし、その説明がもっともらしいことと、実際の原因が確認されたことは別です。可児 波起が生成AIとの創作実験とコンテスト応募を進めた「創作大賞」関連の制作記録では、4コマ画像の破綻理由、人物分析、中間発表の結果分析についてAIが説明を行いましたが、一部は可児 波起に否定され、一部は元画像・公式資料・審査理由まで確認できていません。AIのセルフレビューや分析は「原因候補」「仮説」として使い、確認済み事実、説明、仮説、未確認を分けて記録する方が安全です。
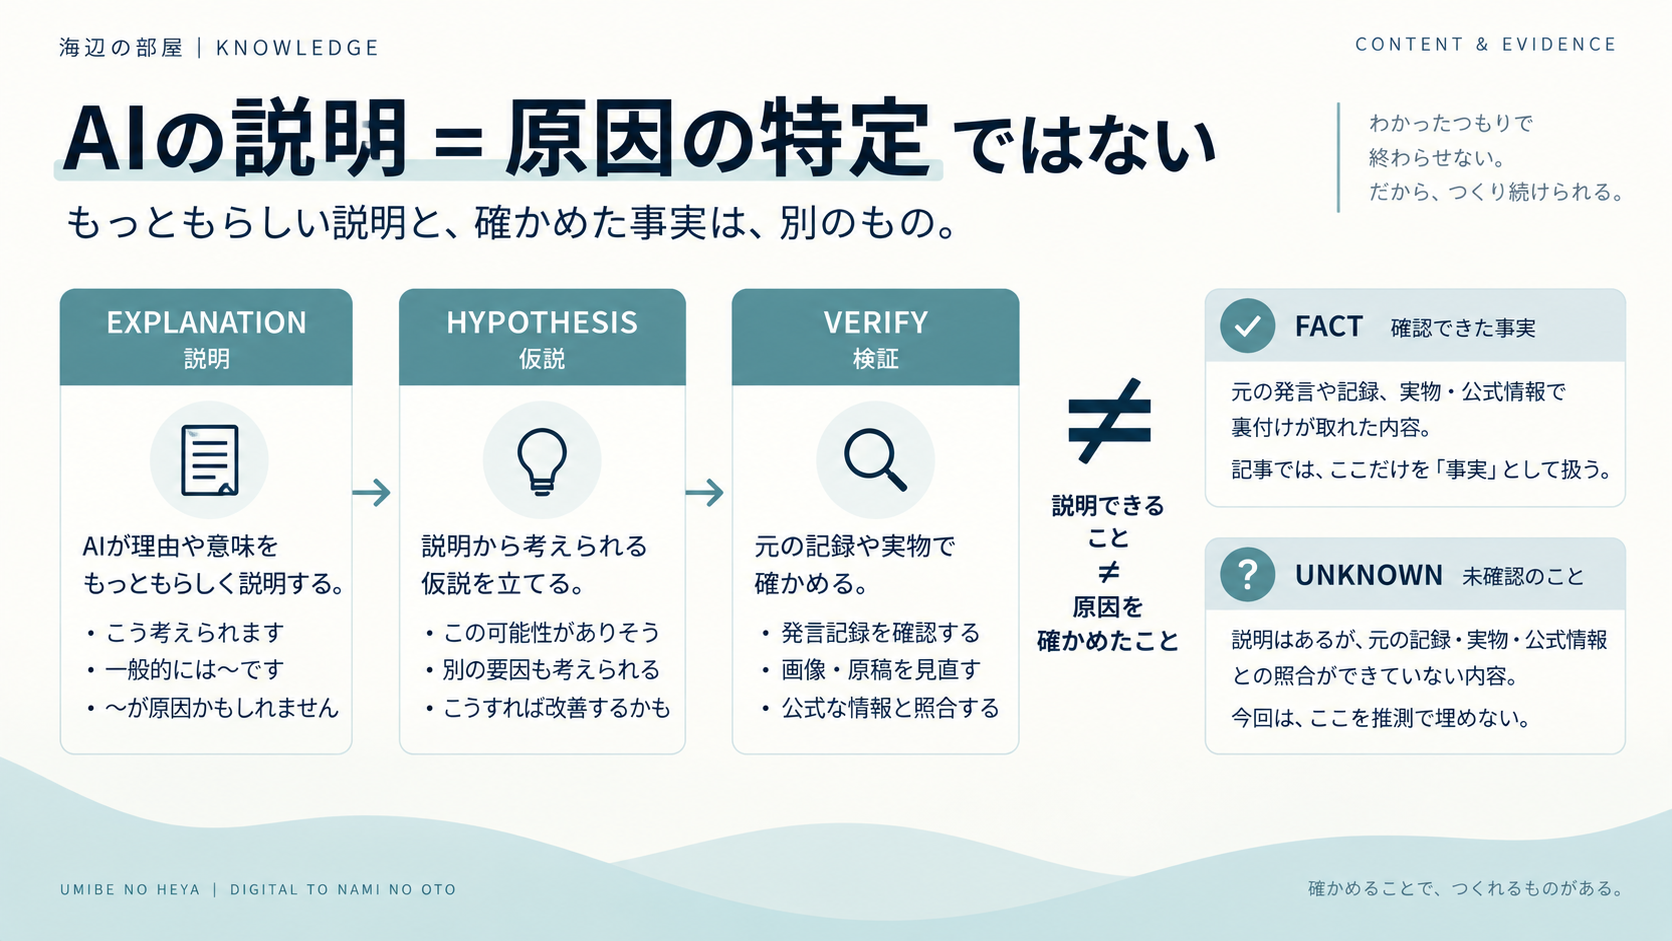
Explanation
【詳しく解説】
AIは、失敗の後に「それらしい理由」を作ることができる
画像が崩れた。文章が本人らしくない。コンテストを通過しなかった。
こうした結果の後にAIへ「なぜ?」と聞くと、構図、情報量、人物心理、企画の弱さなど、筋の通った説明が返ってくることがあります。
説明は修正の入口として便利です。
一方で、その説明自体が実際の原因を証明しているわけではありません。
場面1:漫画画像の破綻について、AIは構図・視線・情報量を説明した
可児 波起が生成AIと共同制作した、新聞4コマ漫画へのオマージュシリーズ『朝野家のすみっこ』の一話『外遊び』で、可児 波起は3コマ目と4コマ目の画像破綻を指摘しました。
そのセルフレビューでAIは、3コマ目について左右に分断された構成、人物間の距離、視線誘導の弱さなどを挙げました。
4コマ目については、セリフ過多、配置の混乱、猫の「もち」がオチとして機能していない、と説明しました。
これらは画像を直すための仮説としては使えます。
しかし今回の採掘では元画像を再確認できておらず、画像生成モデル内部で何が原因だったかも確認できていません。
場面2:人物分析は、もっともらしくても本人に否定された
実体験エッセイ制作では、AIが可児 波起の動機を「承認欲求」で説明する分析を行った記録があります。
しかし、可児 波起はその分析を明確に否定しました。
ここで重要なのは、AIが文章として説明を成立させられたことと、その人物理解が正しかったことが一致しなかった点です。
人物や動機のように外から直接確認しにくい対象ほど、AIの説明を本人の事実として扱わない必要があります。
場面3:コンテスト結果の説明と、審査理由は別だった
可児 波起が複数作品を応募した創作コンテスト「創作大賞」の中間発表後、AIは通過作品の特徴や「作者が見えない作品」「AIらしく見える表現」などについて分析を行った記録があります。
一方、この採掘時点では、審査員が実際にどの理由で各作品を選んだかという公式な個別審査理由は確認できていません。
つまり、結果について説明できることと、選考理由を知っていることは別です。
結果から原因を逆算するときは、説明が自然でも仮説のまま残す必要があります。
セルフレビューは「正解発表」ではなく、次の検証候補を作る工程にする
AIのセルフレビューを使わない方がよい、という話ではありません。
画像破綻後に「1コマ1場面」「左右分断禁止」「4コマ目セリフ最大2つ」へルールを変えたように、説明は次の修正案を作る材料になります。
ただし、その説明を「原因が分かった」と記録すると、後から事実と仮説を区別できなくなります。
セルフレビューの役割を、原因の確定ではなく、次に試す仮説を作ることと定義すると扱いやすくなります。
記録では4つのラベルを分ける
海辺の部屋では、同じ出来事について次の4つを分けて残すと整理しやすくなります。
- RESULT / FACT:確認できた結果・発言・出来事
- EXPLANATION:AIや他者が行った説明
- HYPOTHESIS:原因として考えられる仮説
- UNKNOWN:現時点では確認できていないこと
たとえば「3コマ目が破綻した」はRESULTです。
「左右分断が原因だった」は、元画像や比較実験で確認するまではHYPOTHESISです。
AIの説明と、一次情報の確認を同じ欄に置かない
AIの分析文は読みやすいため、後から見ると事実そのもののように感じやすくなります。
そこでEvidenceでは、本人発言、画像、公式資料、実測値などと、AIによる事後分析を別に記録します。
OpenAI公式も、ChatGPTは誤った情報やもっともらしい誤答を出すことがあり、重要な情報は信頼できる情報源で確認するよう案内しています。
これは、AIのセルフレビューや原因分析についても「確認できるものは別経路で確認する」という姿勢と整合します。
AIのセルフレビューを使う基本形
- まず確認できた結果を記録する
- AIへセルフレビューさせる
- 説明を原因候補へ分解する
- 本人発言・原画像・原稿・公式資料などで確認できるものを探す
- 確認できない説明はHYPOTHESISとして残す
- 修正案を試し、結果を次のEvidenceとして追加する
- 説明が外れていた場合も消さず、訂正履歴として残す
AIの説明は、答えではなく出発点として使えます。
もっともらしさと、確認された原因を分けることで、セルフレビューを安全に再利用できます。
このKnowledgeの関連知識
定義を確認する: 見た目が近い数値や説明から原因を補完せず、比較対象の定義が同じかを先に確認する。
売上総額がほぼ同じでも、集計基準が違えば同じデータではない――注文日と発送日の実例
現在地: CONTENT & EVIDENCE → Evidence・検証状態
EVIDENCE
【根拠・検証】
漫画画像の破綻についてAIが原因候補を説明
可児 波起が生成AIと共同制作した、新聞4コマ漫画へのオマージュシリーズ『朝野家のすみっこ』の一話『外遊び』の3・4コマ目への破綻指摘後、AIは左右分断、人物間距離、視線誘導、セリフ過多、オチの弱さなどを説明しました。
今回の採掘では元画像を再確認できておらず、これらは当時のAI分析として扱います。
人物動機のAI分析は本人に否定された
エッセイ制作でAIが可児 波起の動機を承認欲求で説明した分析に対し、可児 波起が明確に否定した記録があります。
この訂正から別の心理的動機を推測することはせず、「AI分析が本人の説明と一致しなかった」という事実だけをEvidenceとします。
中間発表について、AI分析と公式審査理由は別
可児 波起が複数作品を応募した創作コンテスト「創作大賞」の中間発表後、AIが通過作品の特徴やAIらしく見える表現について説明した記録があります。
しかし今回の取得範囲では、公式な個別審査理由や、AIの説明を裏づける審査員コメントは確認できていません。
AI説明の後に制作ルールを変更した事実は確認できる
画像破綻後には「1コマ1場面」「コマ内分断禁止」「4コマ目セリフ最大2つ」「文章のコマ割りと画像プロンプトを先に書く」といった修正方針が追加されました。
ただし、この変更による破綻率の改善は定量測定していません。
原因の確定には不足している資料が残る
修正前後画像、各生成プロンプト、全原稿、当時の公式ツール結果、審査員の個別コメントなどは、今回の取得範囲では揃っていません。
本記事では、AIが説明を行った事実と、その説明が原因として確認されたかどうかを分けて扱っています。
SOURCES
【情報源】
OFFICIAL SOURCE
OpenAI公式:Does ChatGPT tell the truth? ↗
Author
【著者】
可児 波起
マーケティングデザイナー / DXコンサルタント / 音楽家
次に読む
定義を確認する
売上総額がほぼ同じでも、集計基準が違えば同じデータではない――注文日と発送日の実例
見た目が近い数値や説明から原因を補完せず、比較対象の定義が同じかを先に確認する。 この記事では、月次売上を比較するとき、総額がほぼ一致していても、何の日付を基準に集計したかが違えば同じデータとは限りません。筆者が支援する、楽天市場・Yahoo!ショッピングを運営するEC事業の2026年8月楽天売上では、注文日基準が2,537,020円、発送日基準が2,537,034円で差は14円でした。
このテーマをもっと見る
Evidence採掘、出典確認、原因と仮説、引用の層分けを扱う。 現在、このテーマには5件の主要Knowledgeがあります。
上位カテゴリ
AIで作る文章・画像・調査を、根拠が追えて再利用できる情報へ整える。
すべてのテーマから探したい場合は、Knowledge一覧へ戻る。