
ANSWER
【結論】
AIへ判断を求める前に、数量比較・確認事実・価値基準・AI自身の見解など、どの種類の基準で答えてほしいかを共有します。「世界情勢」プロジェクトでは、数字で比べたい場合と数字を離れた見解を聞きたい場合を分けました。基準指定は結論誘導ではなく回答種別の共有です。
Explanation
【詳しく解説】
この記事で扱う「世界情勢」プロジェクトは、可児 波起が国際ニュースやSNS資料をChatGPTと読み解き、背景・構造・自身の見解を整理した会話プロジェクトです。
同じ質問でも、判断基準が違えば答えは変わる
「この企業は強い?」「この政策は良い?」「このニュースは重要?」という問いには、一つの答え方しかないわけではありません。
数字で比べるのか、確認できる事実だけで整理するのか、倫理や人道の観点まで含めるのか、AI自身の見解を聞くのかで、答えの性質は変わります。
AIが間違ったというより、依頼側と回答側で「何を基準に判断するか」が共有されていないだけの場面もあります。
「世界情勢」プロジェクトで、可児 波起自身が前提共有の不足を振り返った
「世界情勢」プロジェクトでは、ある比較について可児 波起が「今この数字で出てるけど、ここは比較して比べてほしいんだとか」と例を挙げました。
一方で、「ここは数字を無視してあかりの本当の気持ちを教えてほしいんだとか」と、別の種類の答えも区別しています。
そのうえで、「やっぱり僕が前提を話さなきゃダメだよね」と振り返りました。
この記録から確認できるのは、求める判断の種類を明示する必要性が、会話の中で本人によって言語化されたことです。
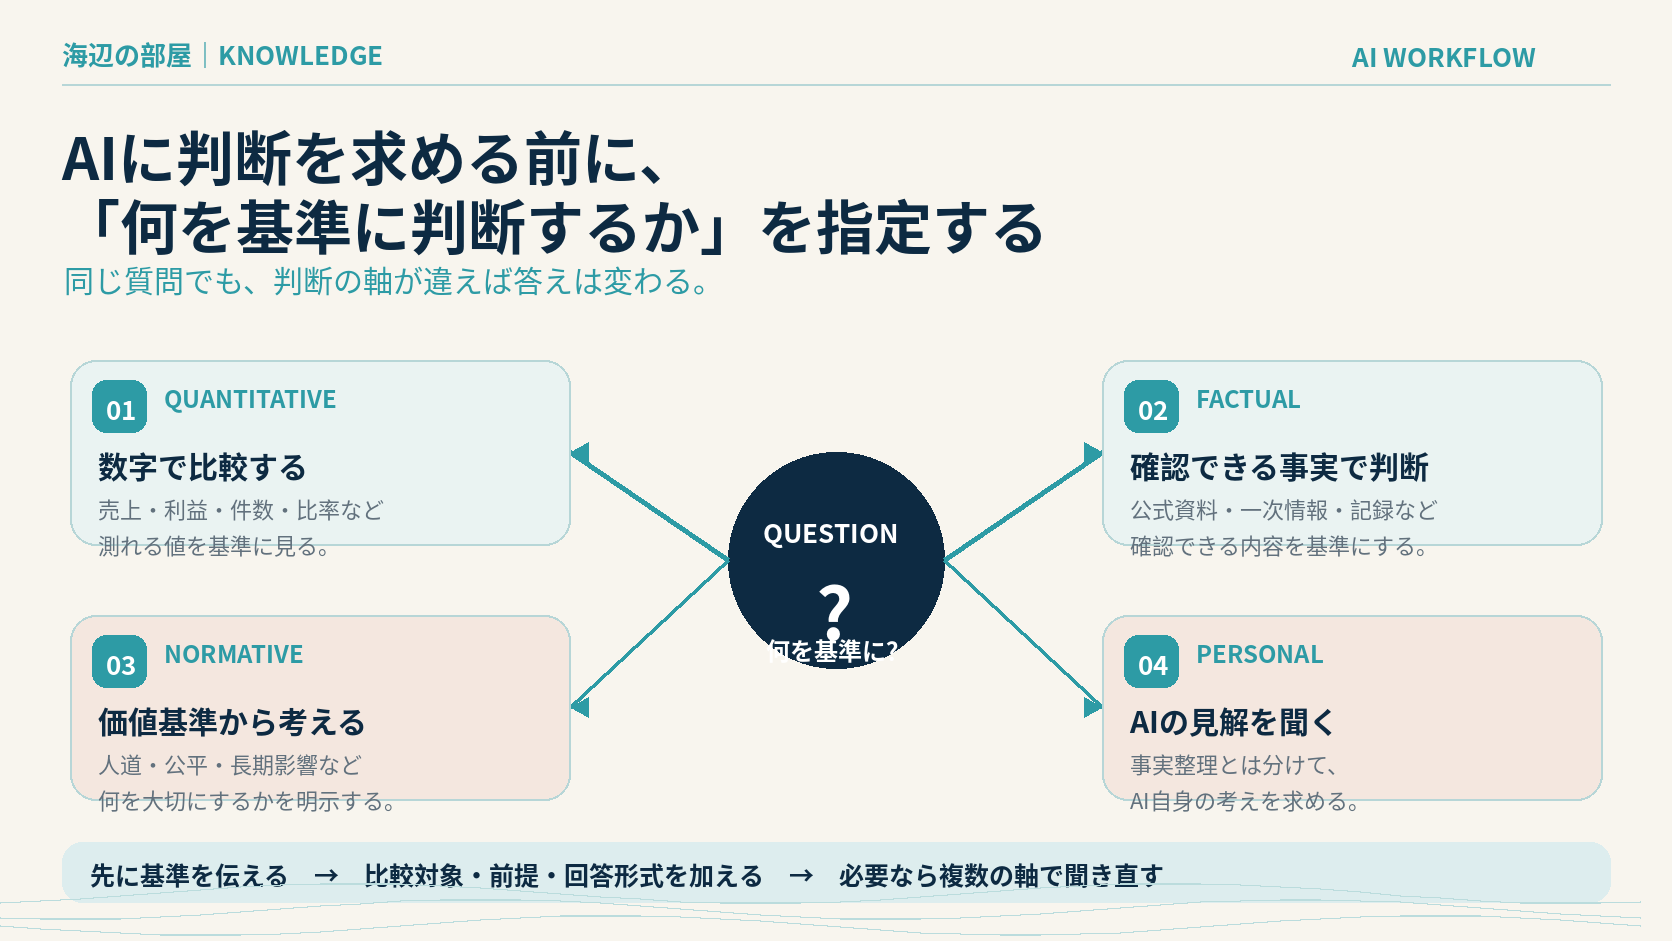
判断基準を4つに分けて考える
実務では、判断基準を次のように分けて伝えると整理しやすくなります。
- QUANTITATIVE:数字、比率、件数、価格、成長率などで比較する
- FACTUAL:確認できる一次情報・公式情報・記録だけで整理する
- NORMATIVE:倫理、公平性、人道、リスクなど、価値基準を含めて考える
- PERSONAL:事実確認とは分けて、AI自身の分析や見解を聞く
同じ問いでも、この4つのどこに重心を置くかで、返すべき情報は変わります。
「事実」と「見解」を同じ回答へ混ぜる必要はない
たとえば、「まず数字と確認事実だけ整理して。その後で、AI自身はどう見るかを別に書いて」と指定できます。
こうすると、検証可能な部分と、分析・解釈の部分を分けやすくなります。
価値判断を求める場合も、「人道面を重視して考えて」「経済合理性を優先して比べて」のように、どの価値を使うかを明示できます。
これは結論を決め打ちすることではなく、評価軸を共有することです。
前提を渡さないと、AIは文脈から基準を推定する
判断基準が指定されていなければ、AIは質問文や会話文脈から、何を重視するかを推定して答えます。
その推定がユーザーの意図と一致する場合もあれば、「そこじゃない」と感じる場合もあります。
前提共有は、AIに察してもらう範囲を減らすためのものです。
特に比較・評価・意見を求める質問では、対象だけでなく判断軸も入力情報になります。
複数の基準を並べて答えさせることもできる
判断軸は一つに限定する必要はありません。
「数字ではA、確認事実ではB、倫理面ではC、最後にAI自身の見解を分けて書いて」のように並列化できます。
複数の軸を分けて出すと、どの基準が結論を変えているのかを比較しやすくなります。
政治や経済のように評価軸が複数あるテーマでは、単一の総合評価へ急いでまとめない方法としても使えます。
判断基準を指定する基本形
- 何を判断したいのかを書く
- 数字・事実・価値・見解のどれを使うか指定する
- 比較対象や期間など、必要な前提を渡す
- 複数軸を使う場合は、混ぜずに分けて出すよう指定する
- 事実とAIの見解を区別する
- 意図と違った場合は、答えだけでなく判断基準を修正する
良い回答を得るために、質問を長くする必要はありません。
「何について」だけでなく、「何を基準に」を一言足すだけで、対話の方向を共有しやすくなります。
AIの商品名提案を絞り込むとき、検索衝突・読み・意味を条件として返すことで候補を変えた。商品名を検討した別の対話では、検索時の重複・読み・意味・製品特徴を条件として返し、名前とコピー案を選択しました。具体的な候補の選別で判断軸を言葉にした例です。
AIに記事を点検させるとき、確認項目と訂正形式を分けて設計した記録。2024年5月の日本語記事の点検では、最新性・日本語表現・誤字脱字・固有名を別々の観点として指定し、訂正を箇条書きで受け取る形を設計しました。判断の対象と回答形式を先に伝えた具体例です。
このKnowledgeの関連知識
レビュー設計へ進む: 判断基準を共有した上で、人間が実際に確認すべき候補量を設計する。
AIで大量制作するとき、「生成する量」と「人間が確認する量」を分ける
現在地: AI WORKFLOW → 判断基準・レビュー設計
EVIDENCE
【根拠・検証】
この記事で扱う「世界情勢」プロジェクトは、可児 波起が国際ニュースやSNS資料をChatGPTと読み解き、背景・構造・自身の見解を整理した会話プロジェクトです。
可児 波起が「数字で比較してほしい場合」を例示
「世界情勢」プロジェクト内で、可児 波起は「今この数字で出てるけど、ここは比較して比べてほしいんだとか」と、数値比較を求める場合の前提共有を例示しました。
数字を離れてAIの見解を聞く場合も区別
同じ会話で、「ここは数字を無視してあかりの本当の気持ちを教えてほしいんだとか」と別の答え方を例示しています。
ここで確認できるのは、本人が「数値比較」と「AIの見解」を異なる依頼として区別していたことです。
前提共有を自分側の課題として振り返った
可児 波起は「でも間違えていたのは僕だと思う」「やっぱり僕が前提を話さなきゃダメだよね」「僕はついついそこを人に求めてしまうところがある」と振り返っています。
これは本人による自己評価であり、元の行き違いについて責任の所在が客観的に確定したことを意味しません。
前提明示前後の改善度は未測定
今回の採掘では、同一質問を「判断基準なし/あり」で比較した実験結果や、回答満足度の数値は確認できていません。
本記事では、判断基準を明示する必要性が本人の振り返りとして言語化されたことをEvidenceとして扱います。
SOURCES
【情報源】
PRIMARY SOURCE|非公開一次記録
可児 波起とChatGPTによる比較・評価の会話記録。AIの判断基準が可児 波起の意図とずれ、評価軸を明示・修正した実例を確認しています。
Author
【著者】
可児波起
マーケティングデザイナー / DXコンサルタント / 音楽家
次に読む
レビュー設計へ進む
AIで大量制作するとき、「生成する量」と「人間が確認する量」を分ける
判断基準を共有した上で、人間が実際に確認すべき候補量を設計する。 この記事では、生成AIで大量の案や素材を扱うとき、AI側で生成・整理する量と、人間が実際に読む・判断する量を同じにする必要はありません。可児 波起が生成AIとの共同制作で複数作品を制作・応募した「創作大賞」プロジェクトでは、当初10作を目標にしたエッセイ企画が17作、さらに86件の素材候補を扱う方向へ広がる一方、可児 波起は「コンテスト版だけ」を提示するよう変更し、文字数確認も事前に行うよう求めました。
このテーマをもっと見る
判断基準、生成量と確認量の分離を扱う。
上位カテゴリ
人間の判断を残しながら、長時間・複数工程の仕事をAIへ任せるための運用設計。
すべてのテーマから探したい場合は、Knowledge一覧へ戻る。