
ANSWER
【結論】
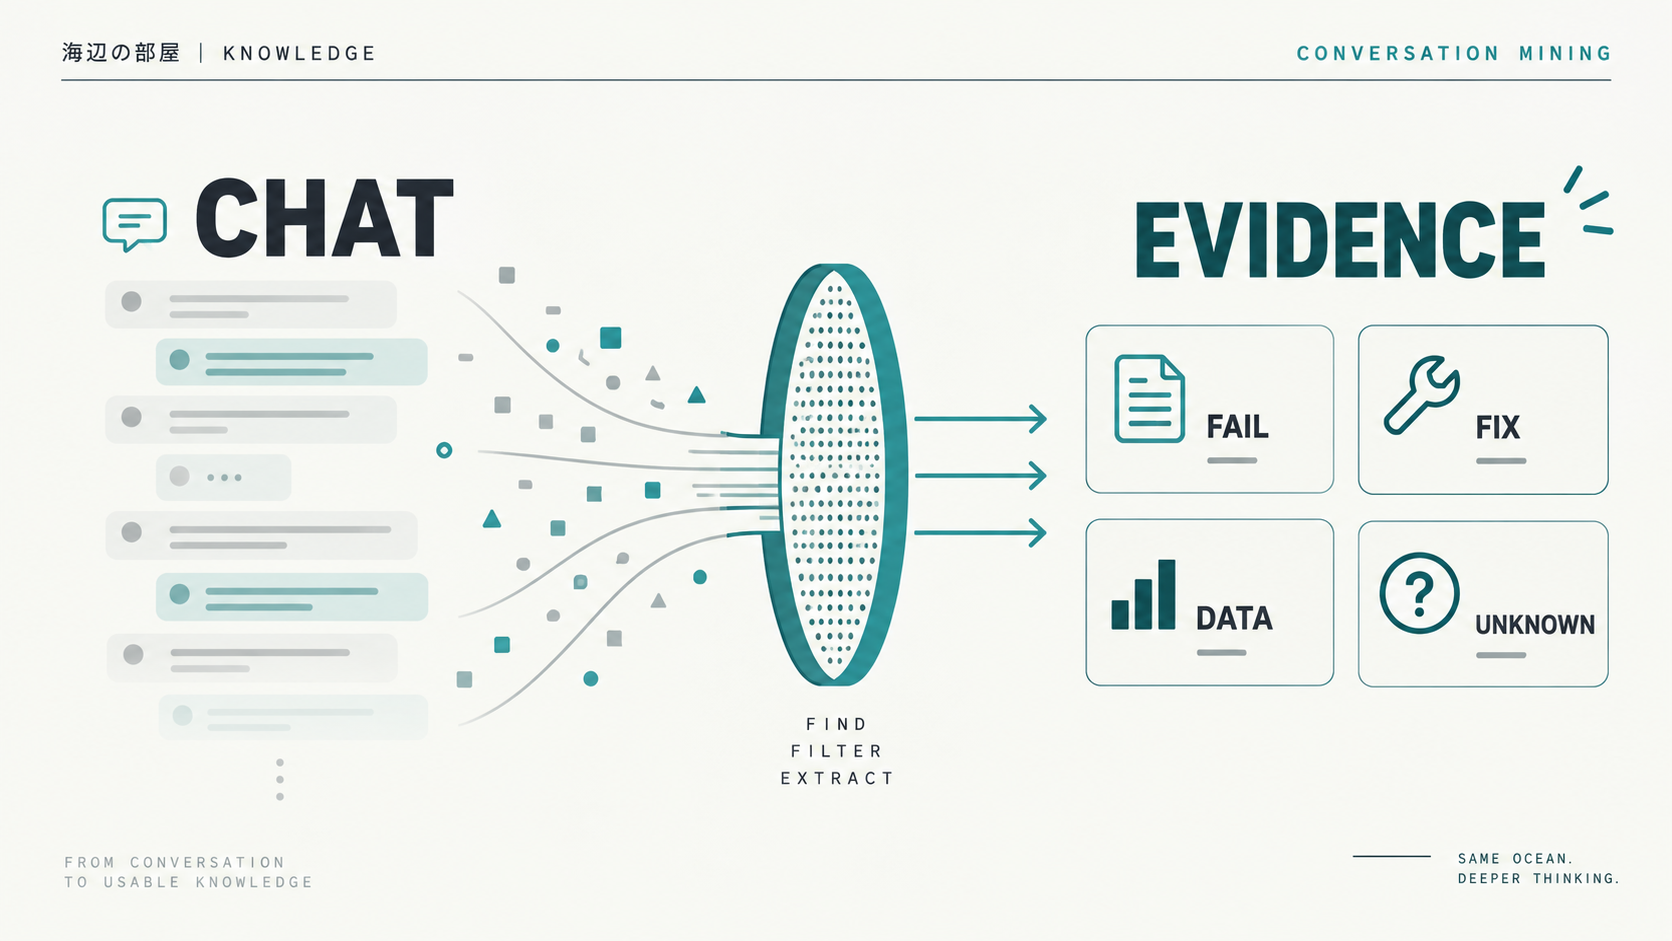
過去のChatGPT会話をKnowledgeやExperimentsへ再利用するときは、会話全体を要約するのではなく、実体験、失敗、手戻り、修正、実測値、検証結果、可児 波起からの訂正、未確認事項をEvidence候補として抽出します。採掘工程では記事化や結論づけまで行わず、素材を残すことに集中し、その後に既存Knowledgeとの重複を照合して、Knowledge・Experiments・Blog・Sourcesのどこへ置くかを判断します。
Explanation
【詳しく解説】
会話を「要約」すると、途中で起きた重要なことが消えやすい
長いChatGPTの会話を振り返るとき、最終結論だけを要約すると、何が決まったかは分かります。
しかし、KnowledgeやExperimentsの一次素材として価値が高いのは、結論だけとは限りません。
途中でAIが間違えたこと、可児 波起が訂正したこと、やり直した理由、実測値、一般論と違った挙動、最後まで確認できなかったことに、再利用できる知識が残っている場合があります。
そのため、海辺の部屋では過去チャットを「短くまとめる」のではなく、あとから検証できる出来事を発掘する対象として扱います。
採掘と記事化を分ける
最初の工程では、良い記事タイトルを考えません。
Knowledgeにするか、Experimentsにするかも確定しません。
まず行うのは、その会話の中で実際に起きたことを、できるだけ取りこぼさず拾うことです。
採掘と記事制作を同時にすると、AIは「きれいな結論」を作ろうとして、途中の失敗や矛盾を削りやすくなります。
そこで、採掘専用の工程では素材抽出だけを行い、重複判定、統合、記事化は別の工程へ回します。
この分離により、一次素材を失わずに、あとからサイト全体を見て配置を判断できます。
発掘する対象を先に固定する
海辺の部屋では、過去チャットから特に次の項目を探します。
- 実体験
- 試行錯誤
- 失敗と手戻り
- 修正と改善
- 独自に加えた工夫
- 実測値と具体的な件数
- 検証結果
- 一般論と違った実際の挙動
- 可児 波起からAIへの訂正
- 途中で変更した作業方法
- 途中で捨てた方法
- 未解決の問題
- 確認できなかったこと
- AIと人間の役割分担
この一覧を先に持つことで、「最終回答に書かれていないから重要ではない」と判断するのを防ぎます。
可児 波起の訂正は、Evidenceとして価値が高い
AIとの共同作業では、可児 波起が途中で「違う」「そこではない」「この数字ではない」と訂正することがあります。
この訂正は、単なる会話上のノイズではありません。
訂正前にAIがどう理解していたか、何が違っていたか、訂正後にどんなルールへ変えたかが残るため、失敗原因と改善策を同時に確認できます。
最終的な成功結果だけを残すより、誤り → 訂正 → 固定ルールの流れを残した方が、次回のAI運用で再現しやすい知識になります。
「確認できなかったこと」を消さない
採掘では、成功した事実だけでなく、確認できなかったことも残します。
たとえば、APIへ送信したが読み戻していない、画面上の表示までは確認していない、原因候補はあるが特定できていない、といった状態です。
未確認事項を無理に埋めると、あとから事実と推測の境界が分からなくなります。
「分からなかった」という記録自体をEvidenceとして残しておけば、後の検証で何を確認すべきかも分かります。
採掘後に、Knowledge・Experiments・Blog・Sourcesへ振り分ける
発掘した素材は、すべてKnowledgeにするわけではありません。
1テーマ1回答として再利用できる結論ならKnowledge、条件・方法・結果・生データを残す価値がある実験ならExperiments、文脈ごと読ませたい体験や考察ならBlog、外部の公式資料ならSourcesへ整理します。
同じ出来事が複数レイヤーにつながることもあります。
重要なのはコピーを増やすことではなく、同じ素材を「読む」「参照する」「検証する」「裏づける」という別の役割へ整理することです。
既存Knowledgeと照合してから、新しい記事にする
採掘で新しい発見が出ても、そのまま新規記事にはしません。
既存Knowledgeのタイトルだけでなく、直接回答、主要なH2、Evidenceまで見て、すでに十分扱っていないかを確認します。
タイトルだけ違って結論が同じ場合や、既存記事の主要H2としてすでに説明している場合は、独立記事にせず既存Knowledgeへの追記候補にします。
採掘工程で重複判定まで行わないのは、個別チャットの内容だけではサイト全体の既存知識を判断しにくいからです。
ChatGPT内の過去コンテンツを探す方法
OpenAI公式では、Projectsで関連するチャット、ファイル、指示をまとめ、継続的な作業で同じコンテキストを利用できると案内されています。
また、ChatGPTのサイドバー検索では、過去のチャット、プロジェクト、ファイルなどを検索でき、チャットのタイトルやメッセージに含まれる語句から過去の会話を見つけられます。
さらに、アカウントのデータエクスポートでは、対象となるアカウントデータのコピーを取得でき、エクスポートされたZIPにはチャット履歴や関連データが含まれます。
つまり、過去会話を資産化するときは「記憶だけに頼る」のではなく、検索や保存済み資料、必要に応じてエクスポートした履歴を元データとして扱えます。
採掘結果は「完成記事」ではなく、Evidence候補一覧として残す
採掘結果の役割は、文章をきれいに完成させることではありません。
後工程で判断できるように、何が起きたか、どこで変わったか、何を確認できたか、何が未確認かを残します。
海辺の部屋では、採掘結果を「素材庫」と考えます。
完成度よりも、あとから事実へ戻れることを優先します。
そのうえで本体側の工程が、重複判定、Knowledge化、Experiments化、既存記事への統合を判断します。
このKnowledgeの関連知識
人物Evidenceへ進む: 会話からEvidence候補を発掘した後、その具体的発言を人物像の主張と結び付ける。
人物像は「性格の要約」ではなく、具体的な会話とEvidenceで書く
検証状態を付ける: 会話からEvidence候補を採掘した後、URL既知・本文確認・該当箇所確認・主張照合の段階を分ける。
現在地: CONTENT & EVIDENCE → Evidence・検証状態
EVIDENCE
【根拠・検証】
過去スレッドを採掘する専用工程を実際に運用
海辺の部屋では、過去のChatGPTスレッドを詳細に振り返り、実体験、試行錯誤、失敗、手戻り、修正、実測値、検証結果、未確認事項、Sources、AIとの役割分担を抽出する専用の採掘工程を作りました。
この工程では、記事本文を書いたり、すぐにKnowledgeへ登録したりせず、まず一次素材を残すことを優先しています。
採掘から14本目のKnowledgeが生まれた
筆者が支援する食品小売事業のWix Blog作業を過去ログから採掘した際、「APIへ送信した」「保存結果が返った」「保存内容を読み戻した」「画面で表示を確認した」を同じ完了として扱っていた問題が見つかりました。
この出来事を別工程で整理し、現在のKnowledge「AIに外部サービスを操作させるとき『送信した・保存された・表示された』を分けて確認する」として独立させました。
会話の最終要約だけではなく、途中の確認不足と修正方針を拾ったことで、再利用できるKnowledgeへ変換できた例です。
重複候補は記事化せず捨てた
一方で、「全置換より部分更新を優先する理由」という候補は、既存Knowledge「ChatGPTとWixでCMS運用を自動化する設計」の主要H2ですでにCreate・Save・Patch・Safe Writeを扱っていたため、独立記事化を見送りました。
これは、採掘で素材が見つかることと、新しいKnowledgeとして独立価値があることが別だと確認できた例です。
現在は、採掘側では素材を広く拾い、本体側で既存Knowledgeと照合してから記事化する二段階運用にしています。
SOURCES
【情報源】
OFFICIAL SOURCE
OpenAI公式:ChatGPT のプロジェクト ↗
OFFICIAL SOURCE
OpenAI公式:チャット・プロジェクト・ファイルを探す ↗
OFFICIAL SOURCE
OpenAI公式:チャット履歴とデータのエクスポート ↗
Author
【著者】
可児 波起
マーケティングデザイナー / DXコンサルタント / 音楽家
次に読む
人物Evidenceへ進む
人物像は「性格の要約」ではなく、具体的な会話とEvidenceで書く
会話からEvidence候補を発掘した後、その具体的発言を人物像の主張と結び付ける。 この記事では、AIに人物像を共有するとき、「多面的な人」「本質を見る人」のような抽象的な性格説明だけを置くと、後からその人物評の根拠を追いにくくなります。可児 波起が国際ニュースやSNS資料をChatGPTと読み解き、背景・構造・自身の見解を整理した「世界情勢」プロジェクトでは、人物像をまとめる際に、可児 波起が「このプロジェクトのみ」「具体的な会話内容を書いて分析」と範囲と根拠を指定しました。
検証状態を付ける
会話からEvidence候補を採掘した後、URL既知・本文確認・該当箇所確認・主張照合の段階を分ける。 この記事では、AIが扱う情報では、「出典URLを知っている」「資料本文を開いた」「関連箇所を確認した」「その箇所が記事の主張を支持していると照合した」を別の状態として記録します。URLが付いているだけで「事実確認済み」と扱わず、重要な主張ほどどの段階まで確認したかを残すと、引き継ぎや再利用の途中で検証状態が過大評価されるのを防ぎやすくなります。
このテーマをもっと見る
Evidence採掘、出典確認、原因と仮説、引用の層分けを扱う。 現在、このテーマには5件の主要Knowledgeがあります。
上位カテゴリ
AIで作る文章・画像・調査を、根拠が追えて再利用できる情報へ整える。
すべてのテーマから探したい場合は、Knowledge一覧へ戻る。