
ANSWER
【結論】
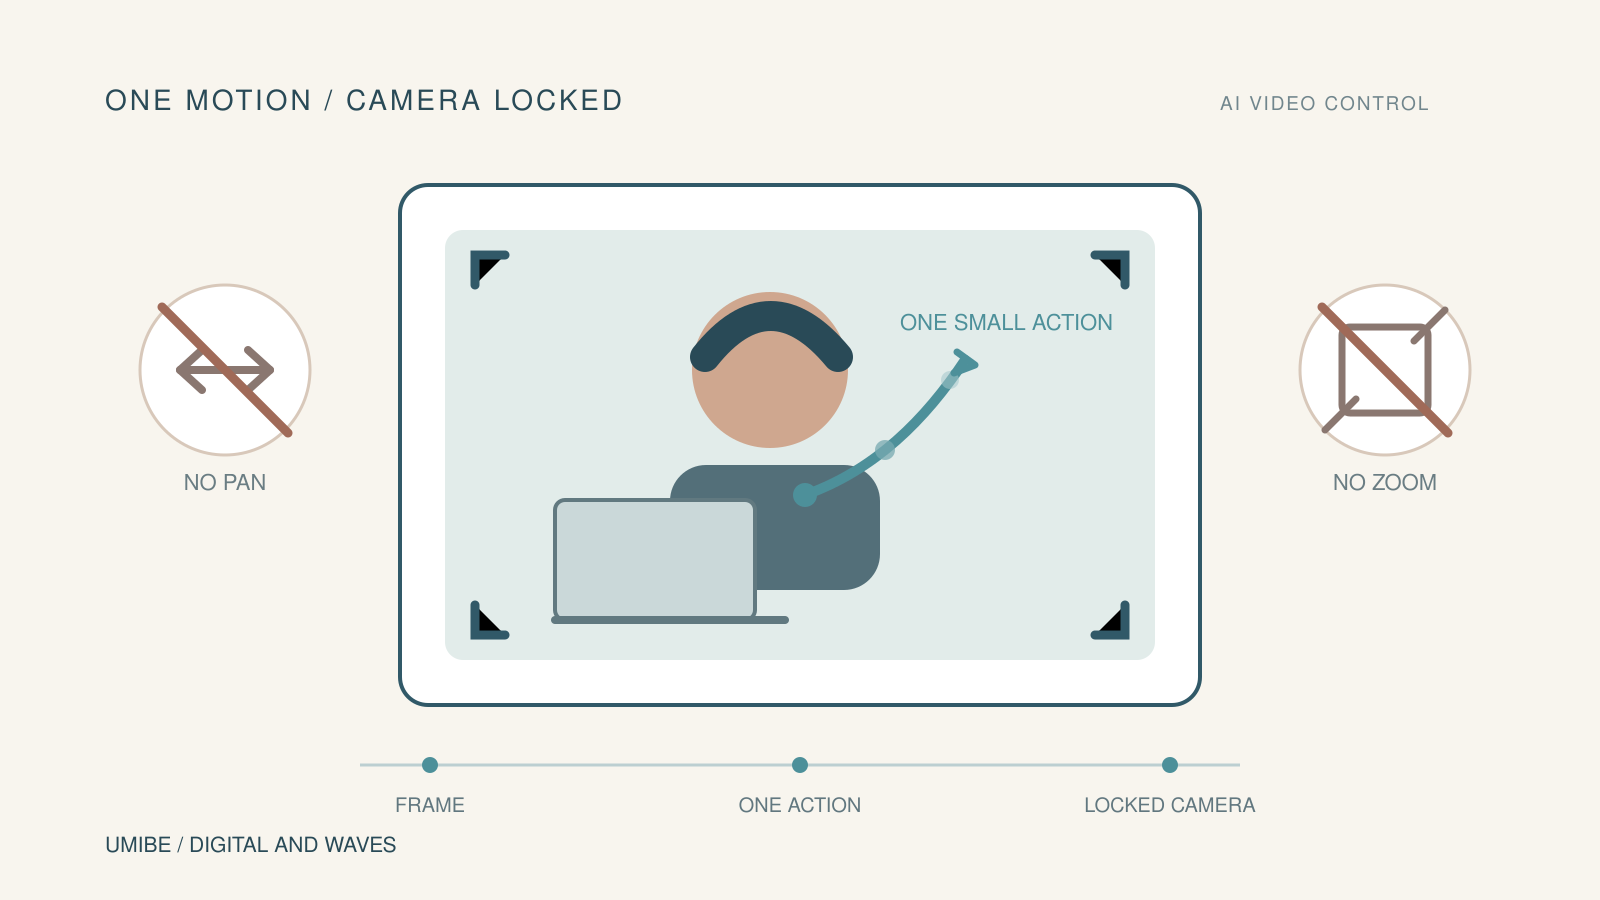
AI動画では、1カットに一つの小さな動作を置き、カメラ固定・ズームなし・パンなしを繰り返してAIへ渡す判断範囲を狭くしました。静止画側で構図を決め、動画AIには画面内の動きだけを担当させた例です。品質向上の因果は未測定です。
Explanation
【詳しく解説】
結論――AIへ「全部演出して」と渡さず、判断させる範囲を小さくした
この制作では、動画AIを監督として使うより、すでに決めた一枚の画へ小さな動きを付ける役割へ寄せました。人物の位置、構図、画角は静止画側で決め、Grokには、そのカットで必要な一つの動きを中心に指定します。
同時にカメラも固定し、ズームやパンを入れず、元画像の配置を維持するよう繰り返し指示しました。これは、AIが勝手に新しい演出を加えないよう、生成時の自由度を意図的に狭くした制作判断です。
1カットへ入れたのは「小さな動き」だった
実際のGrok向けプロンプトでは、手を伸ばす、ネクタイを整える、指が止まる、数文字打つ、スマホを見る、といった小さな動作が中心でした。1カットの中で複数のドラマを完結させるのではなく、その瞬間に必要な身体動作を一つずつ扱っています。
第4ページでは、電車内で数文字入力する、コーヒーへ手を伸ばしかけてスマホへ戻る、会社の廊下で止まってメモする、スマホのメモをPCへ入力するといった形で、カットごとの中心動作が分けられていました。
カメラには「固定・ズームなし・パンなし」を繰り返した
多数の動画プロンプトでは、「カメラ固定」「ズームなし」「パンなし」「元画像の配置を維持」という条件が繰り返されています。
ここで重要なのは、カメラワーク自体が悪いと判断したわけではないことです。この制作では、構図を静止画で先に設計していたため、動画化の段階で再びカメラ位置や画面構成をAIへ考え直させない方針を採りました。
4コマ静止画→切り抜き→固定カメラ、という流れ
一段前では、いきなり動画を作らない――4コマ静止画を設計図にして、1コマずつGrokへ渡した制作方法として、2×2の4コマ静止画を作り、人間が1コマずつ切り抜いていました。
つまり、画面構成は静止画の時点で決め、その切り抜き画像をGrokへ渡し、動画側では構図を維持したまま一つの動きを追加する、という役割分担です。今回の「カメラ固定」は単独ルールではなく、この前工程とセットで使われています。
「1カット1主役」とも違う
既存Knowledgeの全部を同じカットに出すのをやめた――AI短編を「1カット1主役」へ変えた実例では、人物・背景・小道具など、1枚へ同時に要求する視覚情報の数を減らしています。
今回のKnowledgeは、画面に何を出すかではなく、その画面の中で何を動かすかとカメラをどう扱うかの設計です。1カット1主役が視覚情報量の制御なら、1カット1動作+カメラ固定は動画生成時の演出自由度の制御です。
「6秒を1秒ずつ設計する」とも別の層
また、6秒を1秒ずつ設計し、「まだしないこと」まで書いたでは、0〜1秒、1〜2秒と時間軸を分けて、物語をどこまで進めるかを制御しています。
今回の問いは時間ではありません。1カット全体で、AIへ任せる演技・カメラ・構図の範囲をどこまで狭くするかです。両方を組み合わせることで、「何を動かすか」と「いつ動かすか」を別々に設計していました。
「動かない」も、一つの動作として使われた
第5ページ3コマ目では、キーボードを打たせず、Backspace付近で指が動くものの押さない、という設計も使われました。
これは次に扱う感情演出のテーマにつながりますが、今回の観点では「大きな芝居を足さず、一つの小さな身体変化だけを動画AIへ渡す」例の一つです。
比較実験はしていない
この制御方法を使った複数のプロンプトは残っていますが、同じ静止画に対して「自由なカメラワーク+複数動作」と「1カット1動作+カメラ固定」を同条件で比較した記録はありません。
そのため、本Knowledgeは「この方法なら破綻しない」とする一般則ではありません。確認できるのは、実制作でAIの演出判断を減らす方向へプロンプト設計を揃え、それを複数カットで繰り返したことです。
確認できたことと、まだ確認できていないこと
確認できたこと:複数のGrokプロンプトで小さな動作を中心に指定したこと。「カメラ固定」「ズームなし」「パンなし」「元画像の配置を維持」を繰り返したこと。第4ページでカットごとに中心動作を分けたこと。第5ページで「押さない」動作も使ったこと。
確認できていないこと:この制約を外した場合との破綻率比較、カメラ固定だけの効果、1カット1動作だけの効果、他モデル・他作品での再現性、完成作品全体への影響。
実務との接続:1カットの動作とカメラ判断を絞って組み立てる映像制作の実例は、海辺の部屋の動画制作ポートフォリオでも確認できます。
このKnowledgeの関連知識
静止画で構図を先に決める:いきなり動画を作らない――4コマ静止画を設計図にして、1コマずつGrokへ渡した制作方法。動画AIへ渡す前の画面設計を見る。
時間軸を制御する:6秒を1秒ずつ設計し、「まだしないこと」まで書いた。一つの動作を6秒のどこで起こすかを見る。
画面内の情報を減らす:全部を同じカットに出すのをやめた。動作ではなく視覚情報量を絞る設計を見る。
EVIDENCE
【根拠・検証】
Evidence
【直接確認できる事実|1カットの動作】
Grok動画では、手を伸ばす、ネクタイを整える、指が止まる、数文字打つ、スマホを見るなど、小さな動作を中心に複数の動画プロンプトが作成されました。
【直接確認できる事実|カメラ制御】
多数のGrokプロンプトに「カメラ固定」「ズームなし」「パンなし」「元画像の配置を維持」が繰り返し指定されました。
【具体例|第4ページ】
電車内で数文字入力する、コーヒーへ手を伸ばしかけてスマホへ戻る、廊下で止まってスマホへメモする、スマホのメモをPCへ入力する、という中心動作がカットごとに分けられました。
【具体例|第5ページ】
キーボードを打たせず、Backspace付近で指は動くが押さない、という「動かないこと」を含む設計も使われました。
【AIによる分析】
これらを、静止画で構図を決めた後、動画AIへ任せる演技・カメラ・構図の判断範囲を狭くする制作設計として整理しました。
【未確認事項】
自由なカメラワークや複数動作との同条件比較、破綻率、各制約の単独効果、他モデルでの再現性は未確認です。
SOURCES
【情報源】
Sources
PRIMARY SOURCE|非公開一次記録
可児 波起とChatGPTによる縦型短編動画制作の会話・Grok向け動画プロンプト記録。1カットごとの小さな動作、カメラ固定、ズームなし、パンなし、元画像の配置維持、第4ページ各カットの具体的動作、第5ページの「押さない手」の設計を確認しています。
確認範囲
このKnowledgeではGrok公式プロンプトガイドや動画モデルの一般性能を根拠にしていません。「判断範囲を狭くした」は実際のプロンプト設計を整理した分析であり、その方法が品質向上を引き起こしたという因果関係は確認していません。
Author
【著者】
可児波起
マーケティングデザイナー / DXコンサルタント / 音楽家
次に読む
構図を先に決める
いきなり動画を作らない――4コマ静止画を設計図にして、1コマずつGrokへ渡した制作方法
動きを時間へ配置する
6秒を1秒ずつ設計し、「まだしないこと」まで書いた――AI動画に物語を先回りさせないプロンプト
画面へ出す情報を絞る
全部を同じカットに出すのをやめた――AI短編を「1カット1主役」へ変えた実例
このテーマをもっと見る
AI映像の生成尺、時間軸、ショット単位の情報設計を扱う。
上位カテゴリ
人間とAIの役割分担、漫画・映像・物語制作、作品のContinuityを、実制作のEvidenceから整理する。