
KNOWLEDGE
過去のAI体験を「当時の限界×人間の工夫」として残す――dotローンチ直後に歴史Knowledgeの型を作った記録
著者:可児波起
確認日:
2026年10月3日
更新日:
2026年10月3日
ANSWER
【結論】
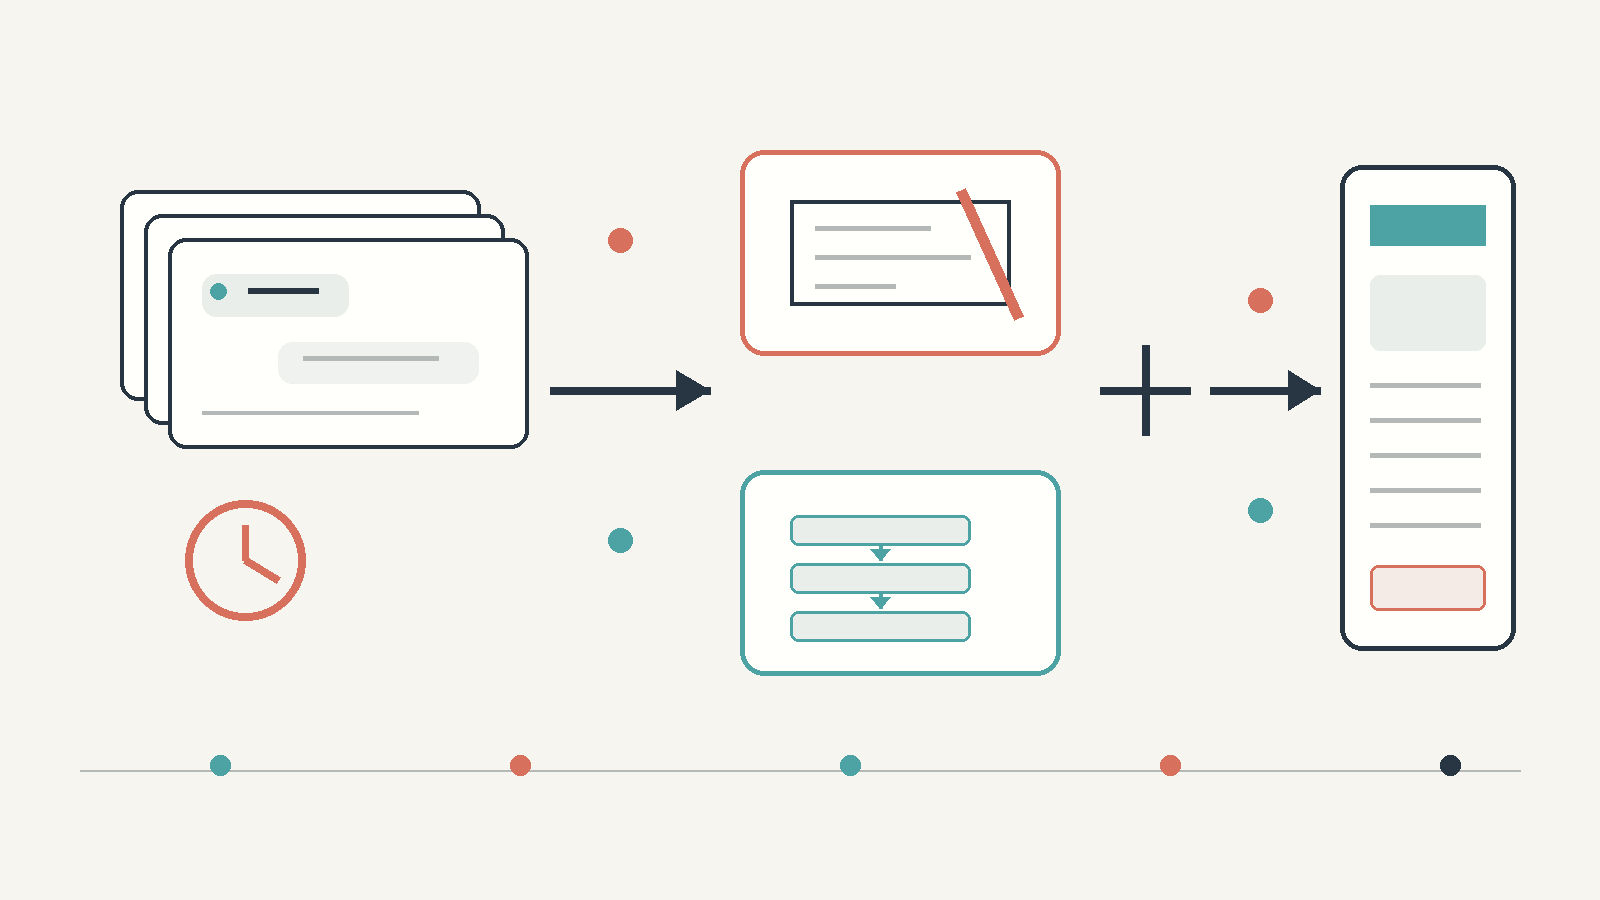
過去の生成AI体験をKnowledgeにするとき、2026年10月1日〜2日の可児波起とChatGPT dotの試行では、現在のAI基準で昔を採点するのではなく、「当時の生成AIの限界」と「それに対して人間がどう工夫したか」を一組で残す方法へ変わりました。採掘した原会話に当時の事実調査と本人回想を重ね、記事の問いと答えを決めてから執筆・セルフレビュー・公開確認へ進む型が作られ、2023年6月の長文制作記事を見本として残り5記事へ展開されました。
Explanation
【詳しく解説】
古い会話を探したのは、今では再現できない試行錯誤を残すためだった
dotローンチ直後のKnowledge制作では、最初は最近の似た会話を連続して採掘しました。しかし、3スレッドを処理しても新規Knowledgeは0件となり、既存記事の改善に寄りました。
可児波起はそこで、新規Knowledgeを増やすことが主目的だと訂正し、探索先を2023年以降の古いChatGPT利用へ移しました。本人が価値を置いたのは、現在の生成AIでは見えにくくなった初期の驚き、失敗、工夫、記憶の弱さへの対処、長文を作るための分割など、当時の利用者側の試行錯誤でした。
現在の正解から過去を採点する聞き方は、本人から拒否された
古いプロンプトやSEO運用を振り返る途中、AI側は現在の考え方から当時の方法を評価する質問へ寄りました。
これに対し可児波起は「今の聞き方は嫌だ」「監査を受けてるみたい」と明確に訂正しています。本人が求めたのは、今なら正しいか間違いかを裁くことではなく、その時点で何が分からず、何を試し、どう判断したのかを残すことでした。
この訂正以降、過去のAI利用は現在の正解へ書き換えず、当時の記録として扱う方針が強くなりました。
歴史として読めるだけでは、Knowledgeの答えが弱かった
古い会話から作った歴史記事は、一度、背景や時系列が分かる文章へ大きく改善されました。2023年6月の長文制作記事について、可児波起は「めちゃくちゃ良くなった。これこそ当時の記録」と評価しています。
しかし、その直後に「そこからknowledgeとして何がアンサーなのか?が弱い」と指摘しました。
ここで、歴史を分かりやすく説明することと、特定の問いへ答えるKnowledgeを作ることが別だと整理されました。過去会話は記事そのものではなく、問いと答えを作るための素材として扱う必要がありました。
中心に置いたのは「当時のAIの限界」と「人間がどう補ったか」だった
可児波起は、過去のKnowledgeで最も残したいものを「当時の生成AIの限界と、それに対して人間がどのような工夫をしたのかの記録」と表現しました。
例えば長文制作なら、「昔は出力が短かった」という性能説明だけでは終わりません。その状況で人間が目次を作らせ、章単位で生成し、「続きを書いてください」と進めていたなら、その人間側の仕事まで一緒に残します。
この考え方によって、過去記事の中心は「昔のAIは弱かった」という評価ではなく、「その条件の中で人間は何をしたのか」へ移りました。
本人回想だけでなく、当時の事実を別に調べてから体験と重ねる工程を加えた
可児波起は、過去のモデル版、機能、出力条件、当時の注意事項などを調べたうえで、「それと、体験をマージする」と指示しました。
この工程では、本人の記憶にある数字や表現を、そのまま公式仕様として扱わないようにしました。例えば本人が価値を説明するために挙げた数値の例と、保存された回答を後から数えた値は分けます。また、別製品の説明やAPIの上限を、ChatGPT画面の仕様へそのまま移さないようにしました。
確認できる当時情報が見つかっても、それが個別の失敗の直接原因だったと確認できなければ、背景情報と原因を分けて残します。
2023年6月の記事で、歴史記録とKnowledgeのAnswerを一つにした
方法を確かめるため、2023年6月の長文ブログ制作記録を1本だけ先に書き直しました。
この試験では、当時の利用環境について調べた内容、保存された回答の計測、当時の依頼条件、後年の本人回想を分けて材料にしました。そのうえで、「当時、GPT-4で長い記事を作るとき、人間はどんな仕事を担っていたのか?」という問いを置き、生成する単位と進行を人間が組み立てていたという答えへ焦点を合わせました。
可児波起は、この修正版について「これでいいと思う。これを型にして、過去の歴史的記事はこう書くというルールを決めて」と指示しました。
型は「6見出し」ではなく、執筆前に問いとAnswerを固定する工程だった
途中では、背景、行動、結果、当時の難しさ、人間の工夫、分かったことなどを整理する案も作られました。しかし、これらを毎回同じ見出しへ押し込む固定テンプレートにはしませんでした。
最終的に残った流れは、原会話を採掘し、当時の事実を調べ、本人の体験と照合し、記事の問いとAnswerを決め、その後に執筆、セルフレビュー、公開確認へ進む工程です。
特に、問いとAnswerを執筆前に決めることが重要になりました。歴史を説明し終えた後で無理に教訓を足すのではなく、どの問いへ答えるためにその歴史を使うのかを先に定めます。
見本1本を残り5本へ展開し、本人が「完成形」と評価した
2023年6月の記事を見本にした後、章別執筆、FAQ、ChatGPTとの対話資料、AI音楽、画像プロンプトなど、残り5本の歴史記事も同じ考え方で修正しました。
修正後の報告に対し、可児波起は「これで完成形」と評価し、さらにネタの採集から公開までを一気通貫で行うフローを書き出すよう求めています。
ここで確認できるのは、少なくともこの6記事について、一本の見本を起点に歴史Knowledgeの制作基準が展開されたことです。すべての題材で同じ品質を永続的に再現できることまで実証したわけではありません。
この方法で残すのは、成功談ではなく当時の条件と対処である
歴史Knowledgeでは、後から見れば非効率だった方法や、失敗した試行も削りません。現在のAIなら簡単にできることでも、当時はどこで止まり、人間が何を足し、何を勘違いし、何を修正したかが一次体験になります。
同時に、本人回想、保存された当時記録、公式資料、現在の記事制作時の解釈は分けます。回想にある具体的な数字を実測値へ昇格させたり、後年の機能を当時使えたものとして書き換えたりしません。
この区別によって、古いAI利用を「昔は性能が低かった」という一文へ縮めず、制約と人間の工夫を一緒に残す歴史Knowledgeへ変えていきました。
このKnowledgeの関連知識
3日間全体の親記録:ChatGPTのdotをローンチ直後から3日間使った――Knowledge制作で失敗しながら役割分担を作った記録。今回の記事は、その中で歴史Knowledgeの作り方が形成された部分を切り出しています。
見本になった記事:GPT-4で長文記事を作るとき、人間が担った仕事――2023年6月の記録と本人回想。歴史記録だけでなく、当時の人間の役割をAnswerへした最初の見本です。
別の歴史例:馴染んだChatGPTとの対話を再開する資料を作るため、人間は整理方法をどう変えたか。当時の目的と人間の修正を中心に整理した歴史Knowledgeです。
EVIDENCE
【根拠・検証】
本人が示した歴史Knowledgeの中心
2026年10月1日から2日の非公開作業会話では、可児波起が古いChatGPT利用を現在基準で監査するような進め方を拒否し、古い時代の試行錯誤そのものを歴史として残すよう訂正しています。
同じ会話で、過去のKnowledgeについて「当時の生成AIの限界と、それに対して人間がどのような工夫をしたのかの記録」と明示し、記事化前には当時の事実を調査して本人の体験と重ねるよう指示しました。
見本記事を作るまでの確認
2023年6月の長文制作記事をテスト対象にし、当時の環境について調べた内容、保存された回答の計測、依頼条件、本人回想を組み合わせる方法が試されました。
最初の改稿について本人は「めちゃくちゃ良くなった。これこそ当時の記録」と評価した一方、「そこからknowledgeとして何がアンサーなのか?が弱い」と再修正を求めています。その後、人間が担った仕事を問いとAnswerへ明示した版を、本人が歴史記事の見本として承認しました。
残り5記事への展開
見本承認後、残り5本の歴史記事を同じ考え方で修正し、dot側からセルフレビュー・公開完了が報告されました。その報告後、可児波起は「これで完成形」と評価しています。
公開・表示・関連リンクなどの当時の完了状態はdotの実行報告として扱います。本記事制作時に、2026年10月2日のすべての操作ログを独立して再実行したわけではありません。
確認できないこと
この方法が他のすべての題材で同じ品質を保証すること、過去記事をこの型へ変えたことで生成AIからの引用が増えたこと、当時のモデル仕様が個々の失敗の直接原因だったことは確認できません。
SOURCES
【情報源】
PRIMARY SOURCE|非公開一次記録
2026年10月1日〜2日の可児波起とChatGPT dotの作業会話。古いChatGPT利用の採掘、現在基準での監査への本人訂正、当時事実の調査、2023年6月記事のテスト改稿、見本承認、残り5記事への展開までを使用しています。
確認範囲
本人の直接発言、本人回想、dotによる調査・計測・公開報告、現在の記事制作時の分析を区別しています。非公開会話のため、原会話への公開リンクは掲載していません。
Author
【著者】
可児波起
マーケティングデザイナー / DXコンサルタント / 音楽家
次に読む
見本記事:実際にこの型の基準となった2023年6月の長文制作記録。
GPT-4で長文記事を作るとき、人間が担った仕事――2023年6月の記録と本人回想
このテーマをもっと見る
AIが書いた内容を何で合格とするか、問い・根拠・レビュー・確認方法を設計するKnowledge群。