
ANSWER
【結論】
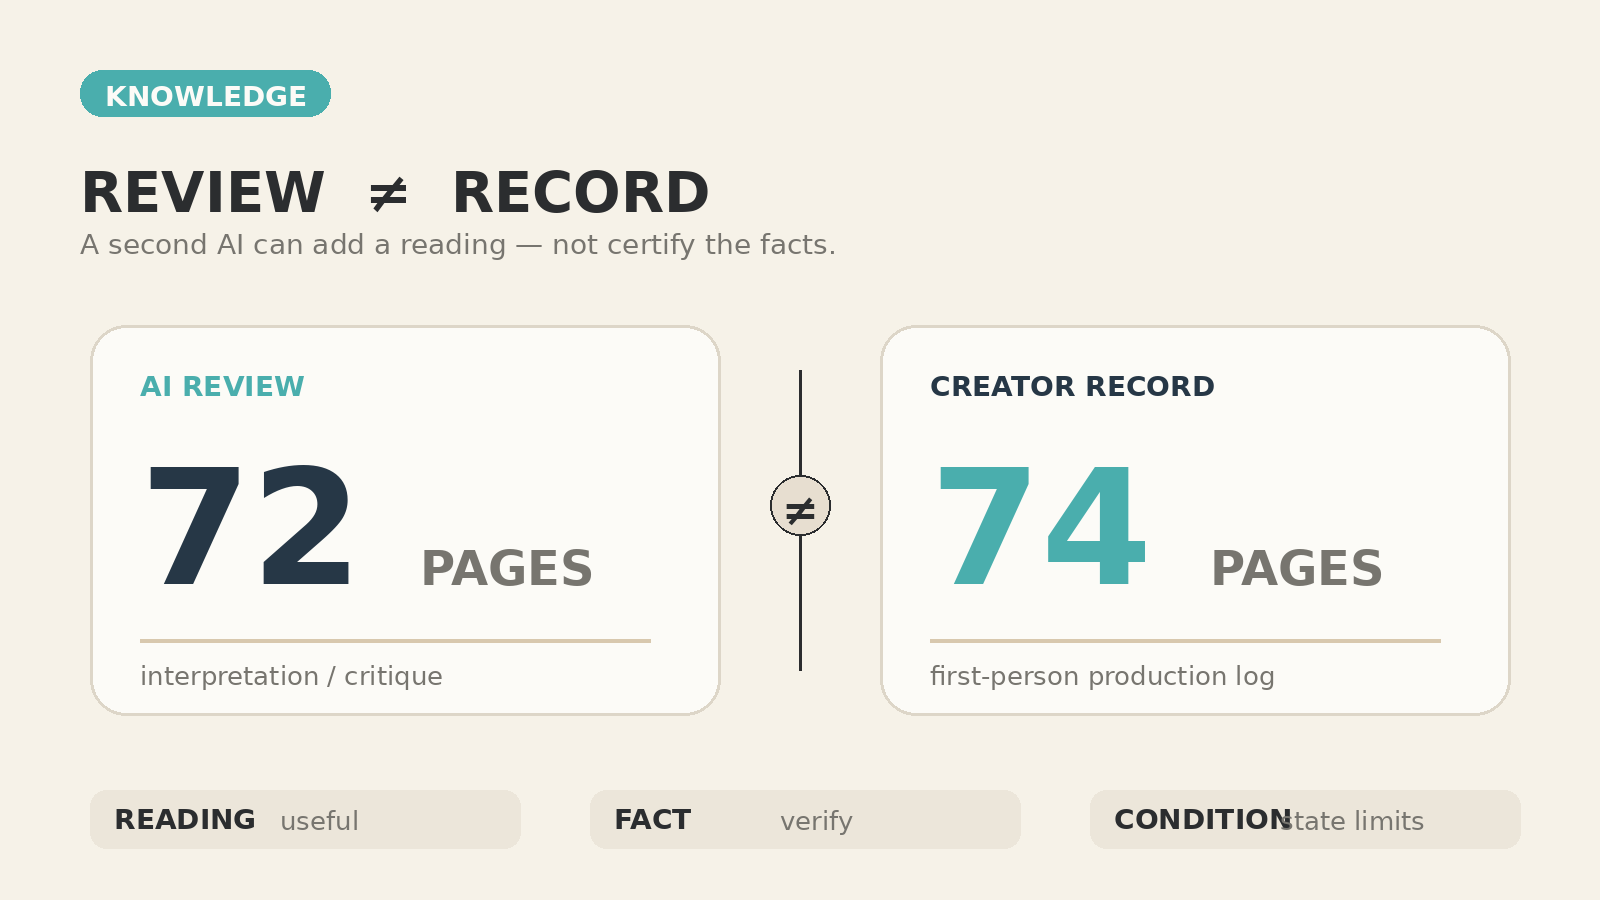
可児 波起が生成AIと共同制作した創作大賞2026マンガ部門向け作品『敗退専門コンサルタント』では、本人がChatGPTの会話へGeminiの総評を貼り付け、別AIが作品のどこを評価したかを比較材料にしました。貼り付けられたGemini文は作品を「全72ページ」と記す一方、可児 波起は制作後に74ページをJPG化したと報告しており、72/74の差の理由は確認できていません。また、Geminiが実際にどの素材を参照したか、モデルや評価条件も未確認です。本Knowledgeでは、別AIの高評価を作品品質の証明ではなく「別の読み筋」として扱い、事実・評価・参照条件を分けて利用する方法を整理します。
Explanation
【詳しく解説】
Geminiの総評をChatGPTの会話へ持ち込んだ
『敗退専門コンサルタント』の制作後、可児 波起はGeminiによる作品総評をChatGPTの会話へ貼り付けました。ここで行ったのは、Geminiの結論をそのまま採用することではなく、別の生成AIが作品のどの部分を拾い、どう読んだかを確認することでした。
会話記録に残るGemini文では、作品のいくつかの構造やモチーフが具体的に評価されています。
Geminiが拾ったのは、物語の構造と繰り返しモチーフだった
貼り付けられたGemini文で評価されていた主な要素は、次の通りです。
- 「ボテボテのゴロ」と「泥」という終盤の具体的なモチーフ。
- 試合描写をすべて説明せず、省略して見せた構成。
- 町民を単なる応援役ではなく、敗退を見届ける存在として置いたこと。
- 生徒 → 町 → 黒瀬玲奈へ感情が移っていく3段階の構成。
- 最後に泥だらけの野球ボールを残した終わり方。
これらは、可児 波起が制作中に積み上げた具体的な演出を、別のAIがどのような意味として読んだかを知る材料になります。
一方で、ページ数は72と74で一致していなかった
同じGemini文には、『敗退専門コンサルタント』(全72ページ)という記述がありました。
一方、可児 波起は制作後に「74ページを全てPhotoshopでjpgで軽くして、重くならないようにしてる」と報告しています。
この72ページと74ページの差は、現時点の記録だけでは理由を確定できません。別バージョンを数えていた可能性、表紙や終了ページを含めるかどうかの違いなどは考えられますが、いずれも確認済み事実ではありません。
したがって、Gemini文を「ページ数まで正確な第三者評価」として扱うことはできません。
評価コメントと、事実らしい記述を同じ信頼度で扱わない
作品評価の文章には、解釈と事実らしい記述が同時に入ります。
- 解釈:泥のモチーフが効いている、感情3段構成が強い、町民が見届け人として機能している。
- 事実らしい記述:全72ページである。
前者は「そのAIがどう読んだか」という評価としてそのまま記録できます。後者は、一次記録や実ファイルと照合して初めて事実として扱えます。
別AIの文章を使うときは、評価がもっともらしいからといって、同じ文章内の数字や前提まで自動的に正しいとみなさないことが重要です。
また、同じ作品でも「何と比べて評価するか」でAIの見え方は変わります。実際に比較母集団を修正した過程は、「新人賞の完成原稿」から「創作大賞の応募棚」へ――比較母集団を変え、AIの評価軸を修正した実例で整理しています。
参照条件が分からないレビューは、独立検証とは言い切れない
今回の記録では、Geminiがどの素材を実際に参照したかを確認できていません。作品全ページを見たのか、要約や一部画像を見たのか、どのモデルだったのか、どのような指示で評価したのかも未確認です。
そのため、ChatGPTとGeminiが似た評価をしたとしても、それだけで「複数AIが独立に同じ結論へ到達した」とは扱えません。入力条件が分からないからです。
複数AIの一致は興味深い観察点にはなりますが、独立した証明とは別です。
複数AIの回答差を比較したい場合は、モデルを増やす前に「何を基準に判断してほしいか」を揃える必要があります。判断基準を先に指定する方法は、AIに判断を求める前に、「何を基準に判断するか」を指定するで扱っています。
別AIのレビューは、5つに分けて読む
この事例から再利用しやすいのは、別AIの回答を丸ごと採用するのではなく、役割ごとに分けて読む方法です。
- 何を拾ったか:自分や最初のAIが見落としていたモチーフや構造がないかを見る。
- どんな解釈をしたか:作品の読み筋として記録する。
- 数字・固有情報は何か:ページ数、日付、制度、固有名詞などは別途照合する。
- 何を見て評価したか:参照素材、モデル、プロンプト、時点が分からない場合は未確認として残す。
- 一致と不一致を残す:複数AIや本人の読みが同じ部分と違う部分を、勝敗ではなく比較材料として残す。
複数AIを使う価値は、「正解を多数決で決めること」ではない
生成AIを複数使うと、同じ対象から別の観点を取り出せます。創作物なら、構造、人物、モチーフ、読後感など、モデルごとに注目点が変わることがあります。
ただし、2つのAIが同じことを言ったから正しい、3つのAIが褒めたから作品品質が証明された、という使い方にはしません。
複数AIは、多数決装置ではなく、観察点を増やすための複数の読み手として使う方が、この事例では扱いやすくなりました。
このKnowledgeで確認できること
確認できるのは、可児 波起がGemini総評をChatGPT会話へ持ち込んだこと、Gemini文に具体的な評価点が書かれていたこと、Gemini文のページ数が72ページだったこと、可児 波起の別の制作記録では74ページと報告されていることです。
「別AIの評価は比較材料として扱う」という整理は、これらの記録と未確認条件を分けたAIによる分析です。
このKnowledgeで確認できないこと
Geminiが実際にどの素材を参照したか、使用モデル、評価プロンプト、72/74ページ差の理由、同じ条件で再評価した場合の再現性は確認できていません。
また、Geminiの高評価が実際の読者評価やコンテスト結果を予測できたかどうかも、この記録からは判断できません。
AIによる作品評価と、実際のコンテスト結果・審査理由は別のEvidenceです。結果と理由を分けて残す方法は、コンテストの結果と「なぜその結果になったか」を分けて記録するで整理しています。
このKnowledgeの関連知識
CONTRAST|別AIを増やす前に、評価の比較母集団を見る
「新人賞の完成原稿」から「創作大賞の応募棚」へ――比較母集団を変え、AIの評価軸を修正した実例
複数AIの回答を並べる前に、同じAIでも比較対象の置き方で評価の重みが変わった実例を確認します。
IMPLEMENTATION|複数AIへ評価を頼む前に判断基準を指定する
AIに判断を求める前に、「何を基準に判断するか」を指定する
モデル間の違いを比較できるよう、評価基準を先に共有する実装へ進みます。
EVIDENCE_RELATED|AI評価と実際の審査理由を分ける
コンテストの結果と「なぜその結果になったか」を分けて記録する
AIの感想・評価と、実際の結果や審査理由を同じEvidenceとして扱わないための接続です。
EVIDENCE
【根拠・検証】
以下は、可児 波起とChatGPTが『敗退専門コンサルタント』を制作・評価した会話記録と、可児 波起が会話へ貼り付けたGemini総評から確認できる内容です。
E33|Gemini文では「全72ページ」と記載
可児 波起がChatGPTへ貼り付けたGeminiの総評には、『敗退専門コンサルタント』(全72ページ)という記述がありました。これは「Gemini文に72ページと書かれていた」ことまでは確認できますが、実際のページ数との一致は別問題です。
一次記録|可児 波起は74ページをJPG化したと報告
同じ制作記録では、可児 波起が「74ページを全てPhotoshopでjpgで軽くして、重くならないようにしてる」と報告しています。72ページと74ページの差の理由は確認できていません。
E34|Geminiが評価した主な構造
貼り付けられたGemini文では、「ボテボテのゴロ」と「泥」、試合描写の省略、町民を見届け人として置いたこと、生徒→町→玲奈の感情3段構成、最後の泥だらけのボールなどが評価されていました。
参照条件|未確認
Geminiがどの素材を実際に参照したか、モデル名、評価時のプロンプト、全ページを確認したかどうかは、この記録では確認できていません。
AIによる分析
「別AIの評価は品質の証明ではなく比較材料として使う」「評価と事実らしい記述を分けて読む」という整理は、上記のEvidenceと未確認条件から導いたAIによる分析です。
SOURCES
【情報源】
PRIMARY SOURCE|非公開一次記録
可児 波起とChatGPTによる『敗退専門コンサルタント』制作・評価会話記録。74ページのJPG化という本人報告と、本人が会話へ貼り付けたGemini総評を確認しています。
EXTERNAL AI OUTPUT|貼付記録
Geminiの総評本文は可児 波起が会話へ貼り付けた文章として確認しています。Geminiが参照した素材、モデル、評価条件は未確認です。
このKnowledgeでは外部Webページを出典として使用していません。Geminiの評価内容は第三者AIの出力であり、作品品質やコンテスト審査結果を証明する一次資料としては扱っていません。
Author
【著者】
可児波起
マーケティングデザイナー / DXコンサルタント / 音楽家
次に読む
同じ作品でも、評価の比較母集団で重みづけは変わる
「新人賞の完成原稿」から「創作大賞の応募棚」へ――比較母集団を変え、AIの評価軸を修正した実例
別AIを増やす前に、そもそも何を比較対象として評価しているかを揃える重要性を確認できます。
AIへ評価を頼む前に、判断基準を決める
AIに判断を求める前に、「何を基準に判断するか」を指定する
複数AIを比較するときも、評価基準を先に共有しておくと、回答差の意味を読みやすくなります。
AIの評価と、実際の審査結果・理由を分ける
コンテストの結果と「なぜその結果になったか」を分けて記録する
作品評価と実際の審査理由を混同しないEvidence管理へ接続します。
このテーマをもっと見る
上位カテゴリ
すべてのテーマから探したい場合は、Knowledge一覧へ戻る。