
Claude Sonnet 5.5で見えたAI価格競争の変化|「トークン単価」から「仕事1件の原価」へ【2026年版】

最終確認:2026年10月2日
2026年9月28日、AnthropicはClaude Sonnet 5.5を発表しました。
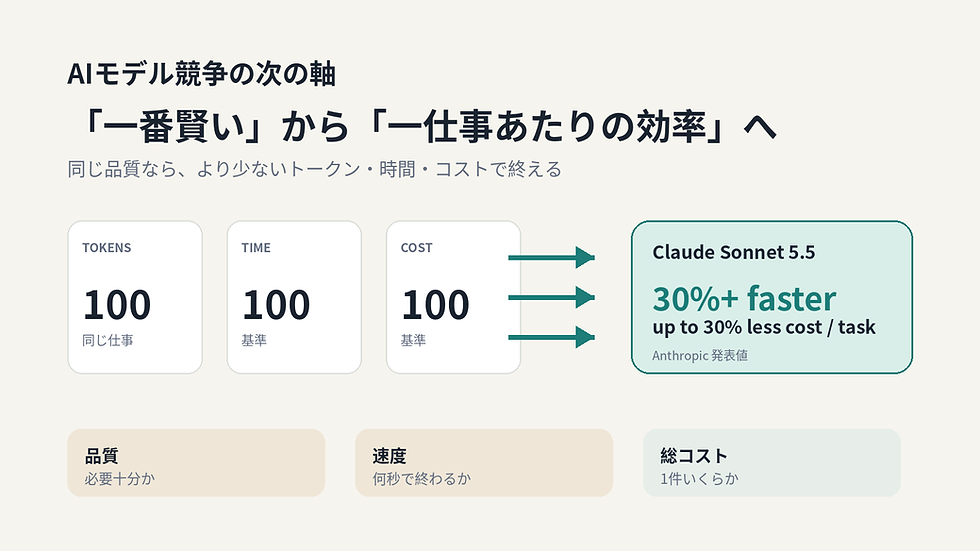
Sonnet 5とAPIの表示価格は同じまま、出力速度は30%超高速化し、同じ仕事に必要なトークンが減ったことで、仕事によっては1タスク当たり最大30%低コストになると説明しています。
新モデルのニュースとして見れば、「前より速く、効率が良くなった」で終わります。
でも企業がAIを大量に使う段階では、この変化はもっと大きい。AIの価格競争の単位が、「100万トークン何ドル」から「仕事1件を何円で終えられるか」へ移り始めています。
Claude Sonnet 5.5で変わったのは「値札」より「仕事1件の原価」
Sonnet 5.5の入力価格は100万トークン2ドル、出力は10ドルで、Sonnet 5から変わっていません。
それでもAnthropicが最大30%低コストと説明できるのは、同じ仕事を少ないトークンで終えられるからです。
つまり、価格表だけ見れば同じ。でも実際に一つの仕事を完了するまでに使う計算量が減れば、企業が払う実質コストは下がります。
「単価が安いモデル」と「仕事を安く終えられるモデル」は同じではありません。
これまでは「どれだけ賢いか」を比べればよかった
生成AIが登場してから、モデル比較の中心はベンチマークでした。
推論、コーディング、数学、長文理解。新モデルが出るたびに、前モデルを何点上回ったかを見る。
この比較は今も必要です。
ただ、企業利用ではモデルが一日に数回使われる道具から、何千・何万回も呼び出される業務インフラへ変わっています。
利用回数が増えるほど、性能差だけでなく「その性能を何円で繰り返せるか」が経営上の差になります。
1トークンの価格より、やり直し回数の方が高くつくことがある
モデルAのトークン単価がモデルBの5分の1でも、仕事を終えるまでに何度もやり直しが必要なら、最終的なコストは逆転します。
人間が修正する時間、再実行、外部API、待ち時間、失敗したエージェントの処理まで含めると、トークン価格だけでは比較できません。
逆に少し高いモデルでも、一度で正しい成果を返し、人間確認も少なければ安くなる場合があります。
企業AIの原価は、「モデル単価 × 使用量」だけではなく、「仕事を完了するまでの総コスト」で見る必要があります。
Anthropic自身も「どの仕事をどのモデルへ渡すか」を前面に出している
Claude 5.5世代では、Anthropicはモデルの使い分けをかなり明確にしています。
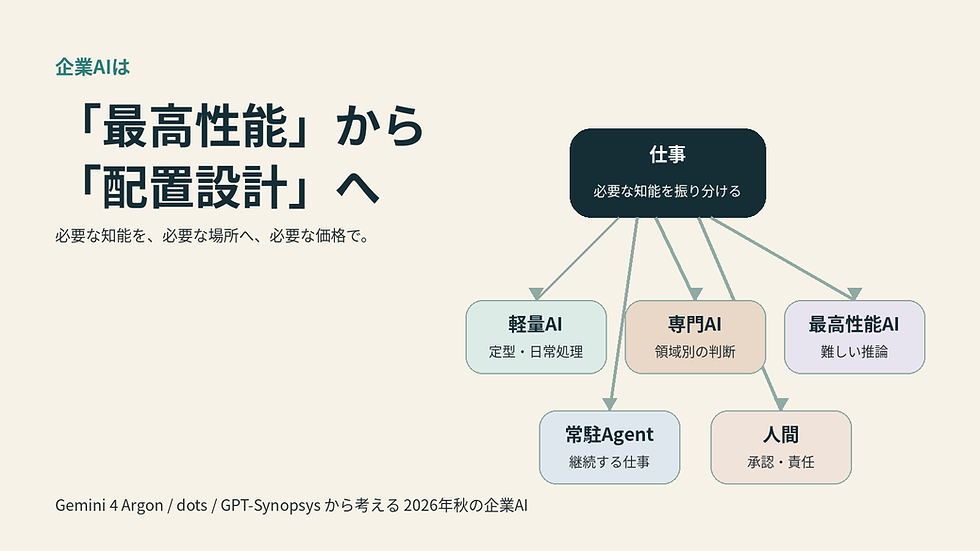
複雑な判断や難しい仕事にはOpus、日常業務や定義のはっきりした仕事にはSonnetという役割分担です。
これは「SonnetがOpusより弱いから安い」というだけではありません。
仕事によって必要な知能が違う以上、毎回もっとも高性能なモデルを呼ぶ理由もありません。
モデル選びが性能順位から、仕事の採算へ移っている。
OpenAIとGoogleにも、同じ方向が見える
この変化はAnthropicだけではありません。
OpenAIも用途や価格帯の違うモデルを並べ、GoogleもFlash系を大量処理や低遅延用途へ位置付けています。
各社のモデル構成は違いますが、共通するのは「最高性能モデル一種類で全部を処理する」設計ではないことです。
性能を上げる競争と同時に、必要な品質を安く大量に届ける競争が進んでいます。
AI産業は、最高到達点を競うレースと、日常業務の原価を下げるレースを同時に走っています。
僕の実務では、AIの「高い・安い」をモデル名だけで決めない
僕自身も、AIの利用コストをモデル単価だけでは判断していません。
ChatGPT Workを使ったEC作業では、すべてをWorkへ渡すより、通常Chatで調査・判断を済ませ、最後のブラウザ操作だけWorkへ残した方がクレジット消費を大きく減らせました。
またAPIでも、不要なデータを全部AIへ渡すより、必要なフィールドだけ返す方がトークンを減らせます。
モデル価格を比較する前に、仕事の流れそのものを軽くできないかを見る。
ここからは僕の見方|AIの価格競争は「電気代」より「人件費」に近づく
トークン単価は、電気料金のように比較しやすい数字です。
でも企業が本当に知りたいのは、「このAIを使うと、一つの業務がいくらで終わるか」です。
そこにはAIの利用料だけでなく、人間の修正時間、確認回数、失敗率、処理速度まで入ります。
僕には、AIの価格比較が「100万トークン何ドル」という資源価格から、「この仕事を一件終える人件費はいくらか」という業務原価の考え方へ近づいているように見えます。
この視点になると、最安モデルが必ずしも最安ではなくなります。
次に新モデルが出たら、ベンチマークより先に3つを見る
新しいAIモデルが発表されたとき、僕なら性能スコアだけでなく次の3つを確認します。
同じ仕事を終えるまでに何トークン必要か。
何秒かかるか。
何回のやり直しや人間修正が必要か。
価格表ではなく、「成功した仕事1件」のコストを見る。
企業利用が広がるほど、この数字の方が実務には効いてきます。
結論:AI競争の単位は「モデル」から「仕事1件」へ広がっている
Claude Sonnet 5.5は、APIの表示価格を下げずに、速度と必要トークンを改善することで1タスク当たりのコストを下げました。
OpenAIやGoogleも、高性能モデルと低コスト・大量処理モデルを役割で分けています。
性能競争が終わったわけではありません。
変わったのは、企業がAIへお金を払うときの物差しです。一番賢いモデルではなく、一つの仕事を必要な品質で、何秒・何回・何円で終えられるか。
生成AIが業務インフラになるほど、この「仕事1件の原価」がモデル選びの中心になっていくと僕は見ています。
関連記事
テーマ別に読む
この記事を書いた人
マーケティングデザイナー/DXコンサルタント/音楽家。企業・自治体等60社以上のマーケティング・DX支援に携わり、生成AI・Web・EC・データ活用などを実務で検証・発信しています。
参考資料・参照元


コメント