
AIに制作ルールを渡したのに、なぜ同じ説明が必要になった?「保存・読取・適用」を分けて考える【2026年版】


僕は「海辺の部屋」のBlogやKnowledgeをAIに作ってもらうために、書き方や公開手順を資料へまとめて渡していました。
資料を作った理由は単純です。毎回「初めて読む人にも分かる文章にして」「事実と推測を分けて」「この順番で公開して」と、同じ説明をゼロから繰り返したくなかったからです。
ところがdotの実験では、資料を渡した後にも、僕が「それは最初の資料に書いてある」「Knowledgeの基本はこれ」と同じ内容を言い直す場面がありました。
最初は、「長い会話だから前の指示を忘れたのかな」と考えました。
でも記録を見直すと、「忘れた」の一言では説明できませんでした。資料が保存されていること、その作業で読めること、正しい版を選ぶこと、実際の成果物へ適用することは全部別だったからです。
まず、会社の共有フォルダで考えると分かりやすい
たとえば会社の共有フォルダに「記事制作ルール.pdf」が置いてあるとします。
ファイルが存在していても、新しい担当者がそのフォルダへアクセスできなければ使えません。
アクセスできても、読まずに作業を始めれば使われません。
v1.1とv1.2が両方あれば、古い方を選ぶ可能性があります。
最新版を読んでも、実際の記事でルールを守らなければ意味がありません。
「資料を渡した」は、この4段階の一番最初にすぎません。
9月30日、まず「プロジェクト資料を読めない」から始まった
dotの実験を始めた9月30日、最初の段階では、必要なプロジェクト資料を取得できないという報告がありました。
そこで僕は、制作ルールや現在地をまとめた資料を複数添付し直しました。
当時の会話では、最終的に10件の資料がそろったという報告まで進んでいます。
ここでは、資料の内容以前に「その作業環境から資料へ到達できるか」が問題でした。
ファイルがどこかに存在していることと、今回のAIがその場で取得できることは同じではありません。
次に起きたのは「書いてあるのに、制作判断へ使われなかった」こと
10月1日の夜、僕は「最初に書き方の資料を渡していた」と指摘しました。
その後の確認では、元資料の中に、初見読者への説明やKnowledgeの目的など、後から僕が言い直した基準がすでに書かれていたと報告されています。
つまりこの場面では、ルールがなかったわけではありません。
必要な基準は資料に存在していた。それでも、記事を作るときの判断へ十分に反映されていませんでした。
「読める資料がある」と「その資料を制作判断へ適用した」は別です。
古い資料と新しい要求が同時にあると、「覚えている」だけでは足りない
さらに10月2日の確認では、古い資料に残っていた方針と、現在の制作方針が一致していない箇所が見つかりました。
過去の資料では、Knowledgeを人間向けの読み物として強く意識しない方針が残っていました。
一方、現在の制作では「初めて読む人が、いつ・どこで・誰が・何のために何をしたか理解できること」を重視しています。
どちらの資料も存在しているなら、単に多く覚えていることが正解ではありません。
必要なのは、「今の仕事では、どの版・どの方針を優先するか」を決めることです。
同じChatGPTでも、読めるものが同じとは限らなかった
10月2日の後半には、更新したプロジェクト資料を新しいChatから実際に読めるか試しました。
プロジェクト資料は読み取れた、という結果がありました。
一方、別の通常Chatでは、同じように使いたかったSkill本文を取得できないという結果もありました。
この一回の試験だけで「通常ChatはSkillを読めない」と一般化はできません。
でも少なくとも今回の作業では、「同じChatGPTだから、同じ資料が全部見えるはず」という前提では進められませんでした。
執筆する場所が変われば、その場で本当に必要資料を読めるかを確認する必要がありました。
OpenAIの公式資料でも、文脈は「全部の会話」ではない
OpenAIのTasks and memoryでは、dotが会話、関連するChatGPT memory、自分の保存ノートなどを使って仕事を続けると説明されています。
同時に、実際の呼び出しで使われる文脈は、それらの情報から選ばれたものだとされています。
dotが新しいタスクを作る場合も、その仕事に必要な指示と文脈は渡りますが、dotとの全会話が自動的に丸ごと渡るわけではありません。
公式仕様からも、「前に話したから必ず全部入っている」「保存してあるから必ず今回使われる」と考えない方が安全です。
僕は資料利用を「保存・読取・版選択・適用」に分けるようになった
今回の経験を整理すると、資料の受け渡しには少なくとも4段階ありました。
1. 保存・存在
必要なルールや一次資料が、プロジェクト、ファイル、Skillなどのどこかに存在している。
2. 読取可能
今回実際に仕事をするChatやタスクから、その資料へ到達して内容を読める。
3. 版選択
古い資料と新しい資料があるなら、どれを現行ルールとして優先するか決まっている。
4. 適用
読んだ内容が、実際の構成・文章・公開判断へ反映されている。
資料を渡したかどうかではなく、どの段階まで通ったかを見るようになりました。
「読んだ証拠」を求めた理由
後半では、単に「資料を確認しました」という返答だけでなく、実際の読取試験も行いました。
たとえば、指定した資料の特定の章から短い文言を示してもらう。現在地のIDやURLを復元してもらう。古い版と新しい版に差があれば、どちらを使うか説明してもらう。
これはAIを疑ってテストしたいからではありません。
本当に欲しかったのは、「今からこの資料を根拠に仕事を再開できる状態か」の確認です。
受領確認より、作業に必要な部分を再現できるかを見る方が、継続作業には役立ちました。
既存の「作業状態を引き継ぐ」記事とは、見る場所が違う
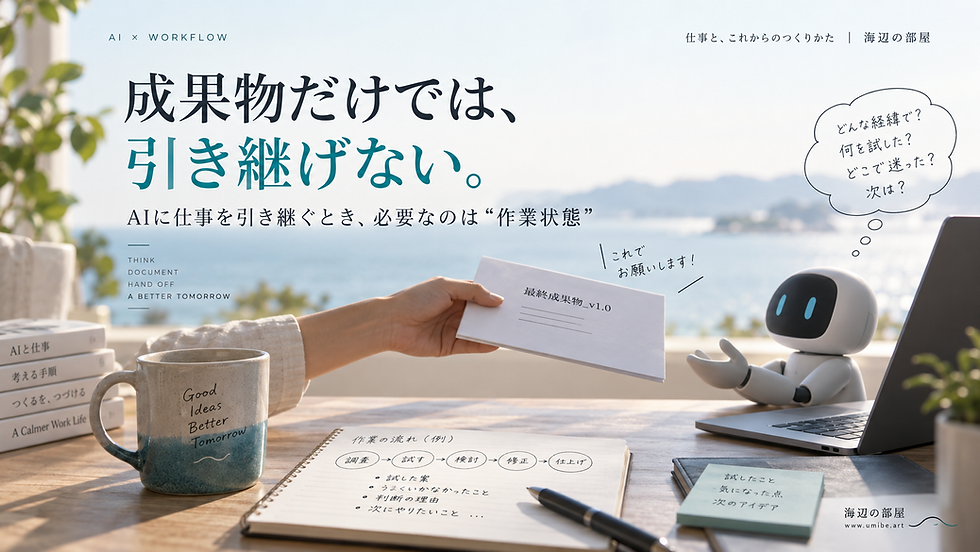
以前の記事では、別スレッドへ仕事を引き継ぐとき、対象ID、完了済み、失敗、未確認、次の操作などの「作業状態」を渡す方法を整理しました。
今回の記事は、その前後にある別の問題です。
作業状態を正しく書いた資料が存在しても、その資料を次の作業環境が読めなかったり、古い版を使ったり、読んでも成果物へ反映しなければ引き継ぎは成立しません。
「何を渡すか」が作業状態の記事なら、今回は「渡したものが本当に使われたか」を見る記事です。
資料を増やせば増やすほど安心、でもない
ルールが抜けるたびに新しい資料を足していくと、一見安全になります。
でも資料が増えるほど、重複や矛盾も増える可能性があります。
v1.1、v1.2、追加メモ、引き継ぎ、Skill、現在地。全部を同じ優先度で残せば、「どれが正しいか」を次のAIが判断しなければなりません。
資料管理の目的は、情報量を最大化することではなく、次の仕事で正しい判断基準を迷わず使える状態にすることです。
僕なら、長いAI案件では3つだけ確認する
今後、長い仕事で制作資料を渡すなら、僕は最低3つ確認します。
一つ目。この作業環境から、必要な資料を実際に読めるか。
二つ目。複数版があるなら、どの版を現行ルールとして使うか。
三つ目。成果物を見て、そのルールが本当に反映されているか。
「資料は渡したから大丈夫」ではなく、「読める・正しい版・反映済み」まで確認する。
これだけでも、「前に説明したはずなのに」をかなり分解できます。
結論:「AIが忘れた」の前に、保存・読取・適用を分ける
今回の実験では、僕がすでに制作ルールを資料へまとめていたのに、同じ目的や書き方を言い直す場面がありました。
それを全部「AIが長い会話を忘れたから」と説明するのは簡単です。
でも実際の記録には、必要資料へ到達できない、古い方針と新しい方針が併存する、ある場所では読めても別の場所では同じものを取得できない、読める資料が成果物へ十分に反映されない、という別々の問題がありました。
資料があること、読めること、正しい版を選ぶこと、成果物へ適用すること。この4つを分けると、「前に説明したのに」がかなり具体的な問題へ変わります。
継続型AIへ仕事を任せるとき、記憶がどれだけ長いかだけを見るのではなく、今回の作業で何を根拠として実際に使っているかを確かめる。
僕はその方が、同じ説明を繰り返さないための現実的な方法だと感じました。
関連記事
テーマ別に読む
この記事を書いた人
マーケティングデザイナー/DXコンサルタント/音楽家。企業・自治体等60社以上のマーケティング・DX支援に携わり、生成AI・Web・EC・データ活用などを実務で検証・発信しています。
参考資料・参照元
可児波起・ChatGPT会話記録および制作資料読取試験(2026年9月30日〜10月3日、非公開一次記録)


コメント