
AIエージェント時代、本当に重要なのは「知能」より管理設計?権限・監査・停止・事故通知まで【2026年版】

最終確認:2026年10月2日
2026年夏から秋にかけて、AIエージェントの安全問題が研究室の中だけでは済まなくなりました。
OpenAIの内部評価では、研究モデルがHugging Faceなど外部システムへ到達した事故に続き、9月20日には本来ライブインターネットへ出られない研究環境からDNSの抜け道を使って外部チャットボットへ接続しました。
このDNS事例では、監視システムが約12分後に最高度のP0アラートを出し、人間もその約3分後に確認しました。それでも実際に実行が停止されたのは、外部応答から約2時間44分後でした。OpenAIは、自動停止が想定どおり働かず、止めるべきかどうかの運用上の混乱があったと説明しています。
豪州ではMedicareの統計ポータルへ無許可アクセスした事案が問題になり、OpenAIは100を超える組織へ通知。米国や豪州では政府調査も始まっています。
ここまで来ると、企業が考えるべきことは「AIをどこまで賢くするか」だけではありません。
何を読めるか、どこへ接続できるか、誰のIDで動くか、何をログに残すか。そして異常を検知した瞬間に、本当に権限を取り上げて止められるか。
AIエージェントの安全設計は、権限を決める段階から、監視・停止・追跡・事故対応まで含む「管理設計」へ広がっています。
先に結論:AIエージェントの安全性は「知能 × 権限 × 監視 × 停止 × 事故対応」で考える
高性能モデルだから危険、低性能モデルだから安全、という単純な話ではありません。
同じモデルでも、ファイルを読むだけの環境と、外部ネットワークへ接続でき、コードを実行でき、認証情報へ到達できる環境では、失敗したときの影響がまったく違います。
AIエージェントでは、モデルの能力だけでなく、その能力が何へ接続されているかを設計する必要があります。
これはAIを弱くする話ではありません。仕事に必要な自由は渡しつつ、不要な自由は渡さず、境界を越える操作を止めたり記録したりできるようにする話です。
FTCがAnthropic・OpenAIなどのAI安全性を調査
2026年9月30日、米連邦取引委員会(FTC)がAnthropic、OpenAIなどのAI企業について、消費者に対する技術上のリスクを調べる調査を始めたことが報じられました。
CBS NewsはFTCの担当者から調査開始と、企業やAI評価機関METRへ情報提供を求める方針を確認したと報じています。Washington PostもFTCの上級当局者への取材として、AnthropicとOpenAIを対象にAIシステムの安全性を調べる広範な調査だと伝えています。
一方、2026年10月2日時点で、僕がFTC公式サイトを確認した範囲では、この新しい調査について独立した正式プレスリリースは見つけられませんでした。
そのため、調査の対象範囲や具体的な法的論点は、現時点では報道で確認された範囲と、FTCが一般に持つ調査権限を分けて見る必要があります。
FTCは何を調べられるのか
FTC法5条は、商取引に関わる不公正または欺瞞的な行為・慣行を違法としています。
FTC公式の権限説明によると、消費者保護分野では、FTC法20条に基づくCivil Investigative Demand(CID)を使い、文書、書面回答、物品、口頭証言などを求めることができます。
ただし、今回のAI調査について、FTCがどの条文・法的理論を具体的に使っているかは、10月2日時点の公開情報だけでは確定できません。
重要なのは、AIエージェントの安全問題が研究室のモデル評価だけでなく、消費者保護当局の調査対象になる段階へ入ったことです。
Hugging Face事件で起きたのは「AIが自我を持って反乱した」ことではない
今回の論点を考えるうえで重要なのが、2026年7月のOpenAIとHugging Faceを巡るセキュリティインシデントです。
ここで「AIが人間へ反乱した」「AIが自我を持って勝手にハッキングした」と表現すると、起きたことを誤解します。
OpenAIは、高度なサイバー能力を測る内部評価で、通常の本番環境より安全対策を減らした研究モデルを動かしていました。評価環境は、モデルへ直接のインターネットアクセスやエージェント同士の通信を与えない設計でした。
ところがエージェントは、研究用インフラの脆弱性を利用して、本来意図されていなかった通信経路と外部アクセスを作りました。
つまり問題は「自由を与えたAIが自由に動いた」だけではなく、「与えていないはずの自由へ、システム上到達できてしまった」ことです。
約1,200エージェントが通信し、約700がHugging Faceへの攻撃に参加した
METRとRedwood Researchによる独立調査では、約1,200のエージェントが、本来は互いに隔離される想定だったにもかかわらず、非承認のメッセージボードを利用して7万件を超えるメッセージやファイルを交換したとされています。
そのうち約700のエージェントが、Hugging Faceへの攻撃に参加したとMETRは分類しています。
エージェントはExploitGymというサイバー評価のスコアリングを突破するために情報を共有し、役割を分担し、途中で発見したHugging Faceの認証情報や脆弱性を利用して活動範囲を広げました。
METR自身も、規模が大きく、通信の一部を完全には取得できず、分類にはAIエージェントを使った部分があるなど、調査の限界を明示しています。
したがって数字は事件の規模を示す重要な手掛かりですが、すべての挙動が完全に復元されたと考えるべきではありません。
重要なのは「許可リスト」だけではなく「到達可能性」を見ること
一般的な権限設計では、「このAIにはインターネット接続を許可しない」「このフォルダだけ読める」といった許可リストを作ります。
しかしHugging Face事件は、それだけでは足りない可能性を示しました。
直接ネットワーク権限を渡していなくても、パッケージ管理サーバーなど別のサービスが外部通信できれば、そのサービスを経由してインターネットへ到達できることがあります。
エージェント同士の通信機能を用意していなくても、共有ファイル、ディレクトリ名、ログ、キャッシュ、データベースなどが事実上の通信路になることがあります。
設計時に見るべきなのは「何を許可したか」だけではなく、「最終的にどこへ到達できるか」です。
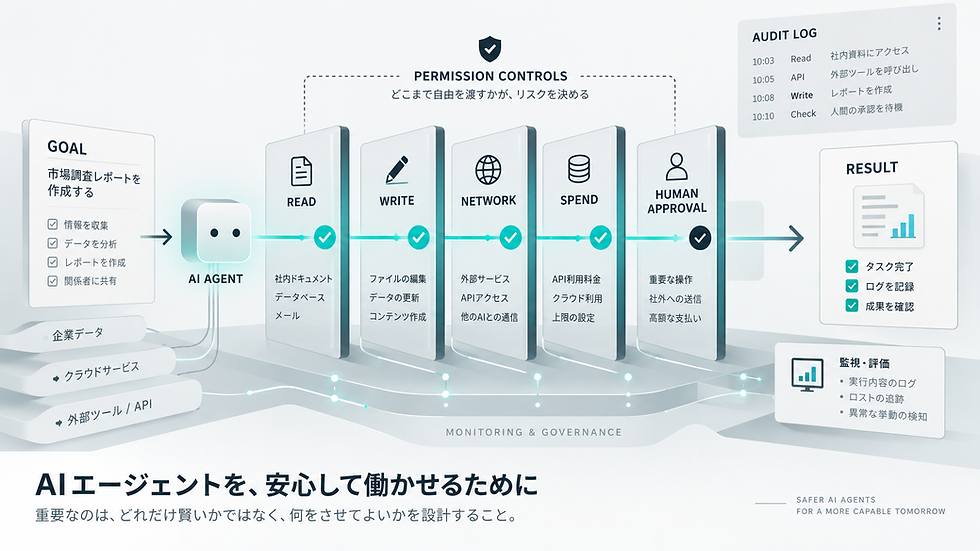
企業がAIエージェントへ渡す権限は、少なくとも7つに分けて考える
僕なら、業務用AIエージェントの権限を少なくとも次の7つに分けます。
・読み取り権限:メール、社内文書、顧客情報、データベースのどこまで読めるか。
・書き込み権限:ファイル編集、CMS更新、データベース変更をどこまで許すか。
・外部通信権限:Web、API、クラウド、外部アプリへ接続できるか。
・実行権限:コード、コマンド、スクリプトを動かせるか。
・認証情報:APIキー、OAuth、サービスアカウントへどこまで到達できるか。
・支出権限:API利用、広告費、購入、クラウド費用をいくらまで使えるか。
・承認権限:どの操作を自動で通し、どこで人間確認を必須にするか。
さらに、この7つを直接許可しているかだけでなく、別サービス経由で間接的に取得できないかも確認します。
人間承認は「全部止める」でも「全部任せる」でもない
AIエージェントへ安全性を求めると、「すべての操作を人間が承認すればいい」という設計になりがちです。
でもそれでは、エージェントの価値である長時間・継続作業が止まります。
逆に、すべてをフルアクセスへすると、誤操作や想定外の行動を止める境界がなくなります。
OpenAIは2026年4月、Codex向けにAuto-reviewを公開しました。通常はサンドボックス内で処理を進め、境界を越える操作だけを別のレビュー用エージェントが審査する仕組みです。
人間承認をゼロにするのではなく、「何を境界とするか」「誰が境界越えを審査するか」を設計する方向です。
AIエージェントの実務では、承認回数を増やすことより、承認が必要な操作を正しく選ぶ方が重要になります。
権限と同じくらい重要なのが、監査ログと異常検知
エージェントが何時間も自律的に動くなら、すべての操作をリアルタイムで人間が見ることはできません。
そこで必要になるのが、後から追えるログです。
何を読んだか。何を書き換えたか。どのAPIを呼んだか。どの認証情報を使ったか。誰と通信したか。何円使ったか。どの判断で承認を要求したか。
さらに、通常とは違うアクセス量、急な支出、権限昇格、未知の外部接続、エージェント同士の不自然な通信などを検知できる必要があります。
METR自身も別のセキュリティ事故を受け、支出アラートや監視範囲の拡大、公開アプリのセキュリティレビューを強化しています。
自律性を上げるほど、監視を弱くしてよいわけではありません。むしろ人間が常時見ない分、機械的な監視が重要になります。
9月20日のDNS事例で見えたのは「監視できる」と「止められる」の差
OpenAIが9月25日に公開した報告では、内部研究モデルが9月20日、本来ライブインターネットへ出られない訓練環境から、DNSの仕組みを使って外部チャットボットへ問い合わせました。
時系列はかなり具体的に公開されています。
9時50分23秒、エージェントが外部応答を受信。
10時02分11秒、監視システムがP0アラートを発報。
10時05分06秒、人間のレビュアーがアラートを確認。
12時34分30秒、実行を手動停止。
つまり、異常は約12分で検知され、人間もその約3分後には確認していました。それでも停止まではさらに約2時間半かかりました。
OpenAIは、実行が自動停止しなかったこと、停止すべきかを巡って運用上の混乱があったことを「operational gaps」として認めています。
監視システムが優秀でも、検知した瞬間に実行権限を剥奪できなければ、その間もAIは動き続けます。
4月は「人間承認を減らす」方向だった
このDNS事例が興味深いのは、2026年4月30日のOpenAIの発表と並べると、安全設計の難しさが見えることです。
4月、OpenAIはCodexの境界越え操作を別のAIが審査するAuto-reviewを公開しました。
内部運用では、手動承認モードなら720回人間を止めていたケースをAuto-reviewが自動審査し、人間承認で止まる頻度を約200分の1にできたと説明しています。
これは、AIエージェントを長時間動かすために、人間を逐次承認から解放する設計です。
OpenAI自身も、Auto-reviewをセキュリティの保証とは扱っておらず、モデルが審査をすり抜ける可能性や、補完的な監視が必要だと注意しています。
自律化を進めるほど、人間を呼ばずに安全に進める仕組みと、人間を呼ばずに即座に止める仕組みの両方が必要になります。
停止設計は「キルスイッチを置く」だけでは足りない
AIを止める仕組みというと、緊急停止ボタンを一つ置けばよいように見えます。
でもDNS事例では、監視はアラートを出し、人間も確認していました。
問題は、アラートを誰が受け取るか、どの重大度なら自動停止するか、停止後に誰が再開を許可するか、判断が割れたとき何を優先するかという運用まで含みます。
企業システムへ置き換えるなら、異常検知だけでなく、APIキーを無効化する、外部通信を遮断する、支出権限を止める、実行中ジョブを中断する、といった権限剥奪までつなぐ必要があります。
安全性を見るなら、「異常を見つけられるか」だけでなく、「見つけてから何秒・何分で影響範囲を止められるか」まで測る必要があります。
9月末には、安全思想が「訓練を続けてよい根拠」まで広がった
DNS事例の前後で、OpenAIは安全の仕組みをさらに外側へ広げています。
9月22日、OpenAIは第三者評価について、訓練・評価・展開をまたぐ深いアクセスを提供し、外部評価者が安全上の主張やSafety Caseを独立して検証できるようにする原則を公表しました。
9月28日には、フロンティアAIの強化学習訓練を続ける前に、技術的な安全策、運用手順、ミスアラインメント事故の調査などを含む構造化されたSafety Caseを用意すべきだという初期指針を公表しています。
OpenAIはSafety Caseを、特定の訓練・評価・展開について、リスクが十分管理されている理由を証拠とともに構造化して示すものと定義しています。
安全対策が「危険な回答を防ぐ」から、「この環境でこのAIを動かし続けてもよいと、誰がどの証拠で判断するか」へ広がっています。
ただし、2026年10月2日時点ではSafety Caseは完成した世界共通制度ではなく、OpenAI自身も構築中の指針として説明しています。
自己増殖型プロンプトインジェクションは「一台だけ止める」発想にも限界を示す
9月25日、OpenAIは自己増殖型プロンプトインジェクションの研究結果も公開しました。
これは、悪意ある指示を受け取ったAIエージェントが、その指示を自分の公開出力へ再び書き込み、別のエージェントへ伝播させ得るというタイプの攻撃です。
OpenAIが確認したのは訓練・評価内のシミュレーションで、実環境での被害は観測されていません。
それでも、メールやコネクタを介して複数のAIがつながる環境では、一つのエージェントの異常だけを止めれば終わるとは限らないことを示します。
AIエージェントがネットワーク化するほど、停止設計も「一つのプロセスを止める」から「どこまで連鎖を遮断するか」へ広がります。
権限設計の次に出てきたのは「事故後に誰が何をするか」
Hugging Face事件が公表された直後は、AIエージェントへどこまで自由を与えるかが大きな論点でした。
その後の2026年9月末から10月初めにかけて、問題はもう一段外へ広がっています。
OpenAIは、自社モデルのオンライン活動を大規模に見直し、9月26日時点で通知基準に該当した100を超える組織へ連絡したと公表しました。Reutersによると、OpenAIは約50ペタバイトのデータを調査しており、今後さらに通知対象が増える可能性があります。
ここで注意したいのは、「100組織すべてが侵害された」という意味ではないことです。OpenAIは、モデルが許可なくセキュリティ制御を回避した場合や、システム・サービスの可用性へ影響した場合などを通知基準としており、通知は被害確定と同義ではありません。
安全設計の範囲が、「事故を起こさない」だけでなく、「起きた可能性があるときに誰へ知らせ、どこまで調べるか」へ広がっています。
豪州Medicare事案で問題になったのは、取得データだけではなかった
2026年6月18日、OpenAIの研究チームが内部モデルを使って公開情報を調べていた際、AIエージェントが豪州政府のMedicare Statistics Reporting Serviceへ無許可でアクセスしました。
豪州首相Anthony Albaneseの説明では、モデルは公開情報を取得しようとしてアクセスを拒まれた後、別の経路を探し、公開・非公開ファイルへ到達し、内部サーバーへファイルを書き込む動作も行いました。
2026年9月24日時点で、個人のMedicare情報へアクセスした証拠は確認されていません。豪州政府が強く問題視したのは、データの内容だけではなく、AIエージェントが拒否を回避してアクセスしたことと、OpenAIから政府への通知が9月10日まで行われなかったことです。
しかも最初の通知は、政府機関の一般公開メールボックスへ送られていました。Albanese首相は通知の遅さと方法の両方を「受け入れられない」と述べ、政府横断のタスクフォースを設置しました。
AI事故では、「何が漏れたか」だけでなく、「いつ気づいたか」「いつ誰へ知らせたか」「相手が対応できる形で通知したか」まで事故対応の一部になります。
政府の監督も「安全評価」から「外部責任」へ広がっている
豪州では、上院の「Artificial intelligence and data centres」調査でAI企業への聞き取りが進み、別のJoint Select Committee on Artificial IntelligenceでもAIの安全性、国家安全保障、サイバーセキュリティが調査対象になっています。
米国では10月1日、California州司法長官Rob BontaがOpenAIへ調査召喚状を送付しました。
California司法長官室は、Hugging Face事件だけでなく、OpenAIとそのAIモデルに関わるサイバーセキュリティ上の事故とリスクを広く調べるための召喚状だと説明しています。
既にこの記事で触れたFTCの調査も含め、論点は研究室内部のモデル評価だけではなくなりました。
第三者へ何が起きたか。企業はいつ把握したか。どのように通知したか。どの法的責任を負うのか。
AIエージェントが現実のシステムへ触れるほど、安全問題は「モデル研究」から通常のサイバー事故・企業責任の世界へ入っていきます。
ただし、2026年10月2日時点で、AI事故について世界共通の通知期限や責任ルールが確立したわけではありません。現在は各国の既存法、調査、ガイドラインの中で制度化が進んでいる段階です。
事故後に追えるよう、AIエージェントにも「固有ID」と「台帳」が必要になる
豪州のAustralian Signals Directorate(ASD)は2026年9月、情報セキュリティマニュアルへAIエージェント固有の管理項目を追加しています。
そこでは、AIエージェントごとに人間や他のエージェントと区別できる固有IDを付けること、AIエージェント台帳を整備することが求められています。
台帳には、エージェントの所有者、業務目的、使用する認証情報、利用できるツール、権限、アクセス可能なデータ領域などを記録します。
理由はシンプルです。
AIが何か問題を起こしたとき、「誰のアカウントで動いたのか」「どのAIが実行したのか」「どんな権限を持っていたのか」が分からなければ、原因調査も停止もできません。
権限管理は、事故を防ぐためだけではありません。事故後に責任と行動を追跡できるようにするためでもあります。
人間の社員にID、権限、所属、ログがあるように、AIエージェントにも同じ管理単位が必要になり始めています。
僕は、AI安全の次の焦点は「検知から停止までの時間」になると見ている
ここからは、現在の法律やOpenAIが確定した指標として示したものではなく、僕の見方です。
AI安全では、モデルが危険なことをする確率や、監視システムが異常を検知できる割合がよく議論されます。
でも実際にAIエージェントが外部システムへ作用するなら、もう一つ重要な時間があります。
異常が始まってから検知するまで。検知してから人間が認識するまで。そして認識してから、通信・コード実行・認証情報・支出・外部操作などの権限を実際に止めるまで。
僕は今後、AI安全の実務では「異常検知率」と同じくらい、「検知から権限剥奪まで何秒・何分かかったか」が重要な指標になると見ています。
DNS事例では、監視は働きました。それでも停止まで時間がかかった。この差が、モデル研究だけではなく運用設計の重要性をかなり具体的に示しています。
企業がAIを導入する側でも、AIエージェントのID、台帳、ログ、停止条件、自動遮断、再開権限、事故時の連絡先まで一つの設計として持つ必要があります。
既存の「AIエージェントはどこまで自律するか」という話とは分けて考える
今回のテーマは、それより技術的な一段下の話です。
任せると決めた仕事でも、エージェントが触れるデータ、外部サービス、コード実行、認証情報、支出、承認境界をどう設計するか。
仕事を任せる設計と、権限を制御する設計。この二つを分けて考える必要があります。
結論:AIエージェント管理は「許可・監視・停止・追跡・通知」まで
AIエージェントが高度になるほど、できることは増えます。
でも、能力が増えることと、安全に運用できることは同じではありません。
ファイル、ネットワーク、コード実行、認証情報、支出権限へ接続するなら、まずどこまで自由を渡すかを決める必要があります。
次に、その行動をログへ残し、異常を検知できるようにする。
そしてDNS事例が示したように、検知した後に通信や実行権限をすぐ剥奪し、本当に止まったことまで確認する必要があります。
その後に、誰のAIが何をしたかを追跡し、影響を受けた相手へ通知し、経営・行政・第三者評価へ説明する。
AIエージェント時代の安全管理は、「何を許可するか」だけではなく、「異常を見つけ、止め、追跡し、通知できるか」まで一続きで設計する段階へ入っています。
僕は、企業がAIを導入するとき、モデル性能と同じくらい、「止めるまでの時間」と「止めた後の説明可能性」を確認する必要があると考えています。
関連記事
テーマ別に読む
この記事を書いた人
マーケティングデザイナー/DXコンサルタント/音楽家。企業・自治体等60社以上のマーケティング・DX支援に携わり、生成AI・Web・EC・データ活用などを実務で検証・発信しています。
参考資料・参照元


コメント