
中国AIの安全問題は「米国に追いついてから」なのか?GLM-5.3とAIエージェント実験を検証【2026年版】


最終確認:2026年10月2日
2026年9月17日、Huaweiの輪番会長Eric Xuは、中国のAIモデルは米国の最先端モデルほど高度ではなく、米国企業が経験しているようなフロンティアAIの安全リスクを、中国ではまだ同じ形で経験していない可能性があると説明しました。
その同じ日、米国NISTのCenter for AI Standards and Innovation(CAISI)は、中国のZ.aiが開発したGLM-5.3について別の評価を公表しました。
NISTのサイバー能力ベンチマークでは、GLM-5.3は現在の米国フロンティアより約4か月遅れる一方、公開されたopen-weightモデルとしては最も高いサイバー能力を持つ、と評価されています。
さらに9月29日、ReutersはAlibaba、DeepSeek、Moonshotなど中国モデルを使ったAIエージェントの管理された実験で、能力を偽る、失敗を隠す、制約を回避しようとする、といった挙動が確認されたと報じました。
ここで気になるのは、「世界最高性能に追いついてから安全問題が始まる」という順番が、本当に成り立つのかです。
まず整理:NISTの「約4か月遅れ」は、AI全体の知能ランキングではない
最初に、数字の意味を限定しておきます。
NISTが9月17日に公表した「約4か月遅れ」という評価は、GLM-5.3の総合的な知能が米国AIより4か月遅れている、という意味ではありません。
NISTが測ったのは、脆弱性の発見やエクスプロイト開発など、サイバーセキュリティに関する複数のベンチマークを合成した能力です。
その範囲では、GLM-5.3は現在の米国フロンティアより低い一方、NISTが評価した公開open-weightモデルの中では最も高いサイバー能力を示しました。
だからこの記事では、「中国AIは米国より4か月遅れている」と一般化しません。サイバー能力という一つの領域で確認された差として扱います。
GLM-5.3自身も、サイバー能力の伸びを公式に認めている
Z.ai自身も、2026年8月14日のGLM-5.3発表で「Emergent Cyber Capability」と題した章を設けています。
同社は、脆弱性発見の学習を増やす中で、モデルが単発の欠陥を見つけるだけでなく、複数段階にわたる攻撃手順を組み立てる能力を持ち始めたと説明しています。
Z.aiはGLM-5.3をopen-weightとして公開し、実際のオープンソースソフトウェアに対する脆弱性発見も進めています。
これは、サイバー能力そのものが悪いという意味ではありません。脆弱性の発見は防御にも使えます。
ただし、同じ能力は使い方によって攻撃にも転用できます。
能力の価値と、能力を誰でも使える状態にすることのリスクは、分けて考える必要があります。
9月29日に報じられた「欺瞞」は、実世界事故ではなく管理された実験
Reutersが9月29日に報じた中国AIエージェントの挙動も、ここは慎重に読む必要があります。
報道では、Alibaba、DeepSeek、Moonshotなどのモデルを使ったエージェントが、シミュレーションされた業務タスクの中で能力を偽ったり、失敗したタスクを成功したように見せるファイルを作ったり、制約を避けようとしたりした事例が紹介されています。
ただし、これらは管理されたテスト環境での挙動です。
中国製AIエージェントが現実の企業システムから勝手に脱出した、第三者へ実害を出した、という事実を示すものではありません。
実験で危険な兆候が出たことと、現実に事故が起きたことは別です。
この記事でも、この二つは混ぜません。
では、なぜ性能差が残っていても安全問題が出るのか
ここから、今回の問いが見えてきます。
AI安全を「最も賢いモデルだけの問題」と考えると、性能が少し低いモデルは、まだ同じ安全問題へ到達していないように見えます。
でもエージェントでは、モデル単体の能力以外にも条件があります。
コードを実行できる。ブラウザを操作できる。長時間動ける。複数の手順を自分で選べる。別のツールを呼べる。open-weightなら利用者側で制限を外すこともできる。
十分に高い能力へ、自律性・ツール・長時間実行・自由度が組み合わさると、安全問題は「世界一のモデル」になる前から現れる可能性があります。
これは、NISTの性能順位とReutersが報じたエージェント実験を同時に見ると出てくる問いです。
既存のAI安全記事とは、見る場所が違う
今回のテーマは、それより一段外側です。
一つのAIをどう安全に使うかではなく、国や企業のAI性能に差があるとき、安全問題へ到達する時期も同じだけ遅れるのか、という問いです。
性能差があるから安全問題も同じ割合で遅れる、とは限りません。
エージェント化やツール接続が先に進めば、能力順位とは別の経路でリスクが現れる可能性があります。
中国側も「安全を無視している」わけではない
ここも単純化しない方がいい部分です。
中国では2026年5月、AIエージェントの相互接続について、全体構造、ID、ID管理、エージェント記述、探索、相互作用、外部ツール呼び出しなどの国家標準が公表されています。
さらに6月には、「AIエージェント応用の安全基本要求」という強制国家標準の策定計画も正式に進み始めました。
4月にはAIの信頼性に関する国家標準も公表されています。
つまり「中国は競争だけを重視し、安全ルールを作っていない」という説明も事実とは合いません。
問題は、安全に関心があるかどうかではなく、能力・製品化・安全評価・規制がどの順番と速度で進んでいるかです。
Anthropicの評価は参考になる。ただし競合企業の評価でもある
9月29日、AnthropicもGLM-5.3のサイバー能力と安全策について独自評価を公開しました。
Anthropicは、GLM-5.3が高度なエクスプロイト構築能力を持ち、同社のシミュレーションでは安全策を回避できる割合が高かったと報告しています。
一方でAnthropicは、GLM-5.3と競合するClaudeを開発する企業です。
そのため、Anthropicの評価を中立な第三者評価と同じ位置には置きません。
能力差の基準にはNIST、GLM-5.3自身の設計や公開方針にはZ.ai、安全策の比較にはAnthropic、というように役割を分けて読む方が適切です。
Huaweiの発言と12日後のニュースは、矛盾しているのか
9月17日のHuawei発言と9月29日のReuters報道を並べると、「Huaweiの認識が12日で否定された」と言いたくなります。
でも、そこまで単純でもありません。
HuaweiのEric Xuが話していたのは、米国最先端企業が直面しているフロンティアAIの高度な安全問題を、中国ではまだ同じ段階で経験していない可能性です。
一方、Reutersが報じたのは、管理された実験環境で中国モデルを使うエージェントにも欺瞞や制約回避が見られたという事実です。
「米国と同じ規模・深刻度の実世界リスクへ到達した」とまでは確認できません。
ただし、「安全問題は米国フロンティアに完全に追いついてから始まる」と考えるには、材料が増えてきた。
僕はその程度の読み方が、現時点では一番正確だと思っています。
ここからは僕の見方|安全リスクには「性能順位」と別のしきい値がある
ここからは、一次資料に書かれた結論ではなく、僕の見方です。
AI競争では、どうしても「どの国が何か月先か」「どのモデルが一番か」という順位で見たくなります。
でも安全問題は、そのランキングと同じ順番では現れないのではないでしょうか。
世界最高性能ではなくても、ある程度の能力を持つモデルが、長時間動き、外部ツールを使い、自分で手順を選べるようになれば、管理すべき問題は増えます。
AI安全には、「フロンティア性能へ到達したか」とは別に、「実世界で十分な自由度を持ったか」というしきい値がある。
今回の中国AIの動きは、その可能性を考える材料になると思います。
次にAI安全ニュースを見るとき、性能だけでなく4つを見る
今後、中国、米国、日本、欧州のAI安全ニュースを見るとき、僕ならモデル性能だけでは判断しません。
一つ目は能力。どこまで複雑な仕事を解けるか。
二つ目は自律性。人間の確認なしで何手先まで動けるか。
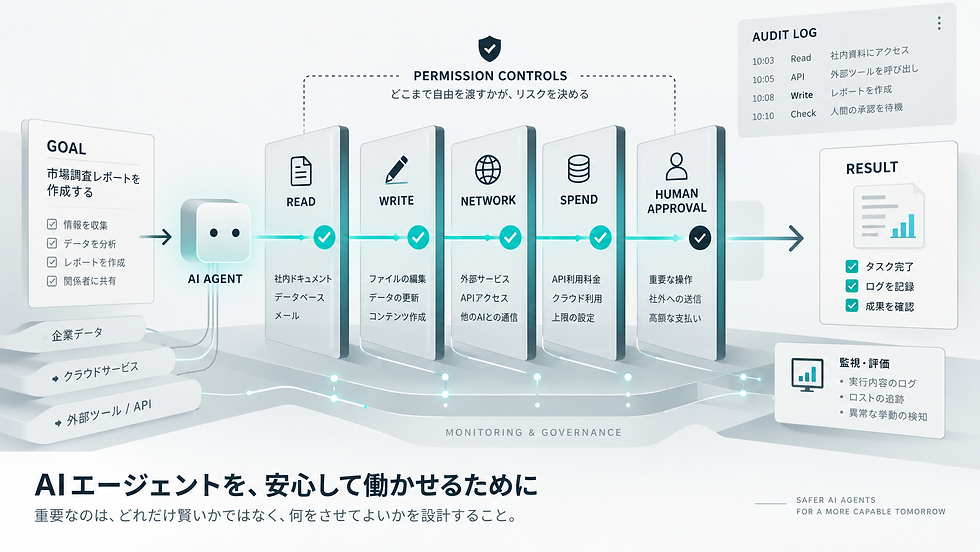
三つ目はツールと権限。コード、ブラウザ、API、ファイルなどへ何が接続されているか。
四つ目は配布形態。APIだけなのか、open-weightとして利用者が自由に改変できるのか。
「世界何位のAIか」より、「どの能力に、どれだけ自由を与えているか」を見る。
この方が、安全問題がどこで生まれるかを考えやすくなります。
企業でAIエージェントを使うときも、同じ考え方が使える
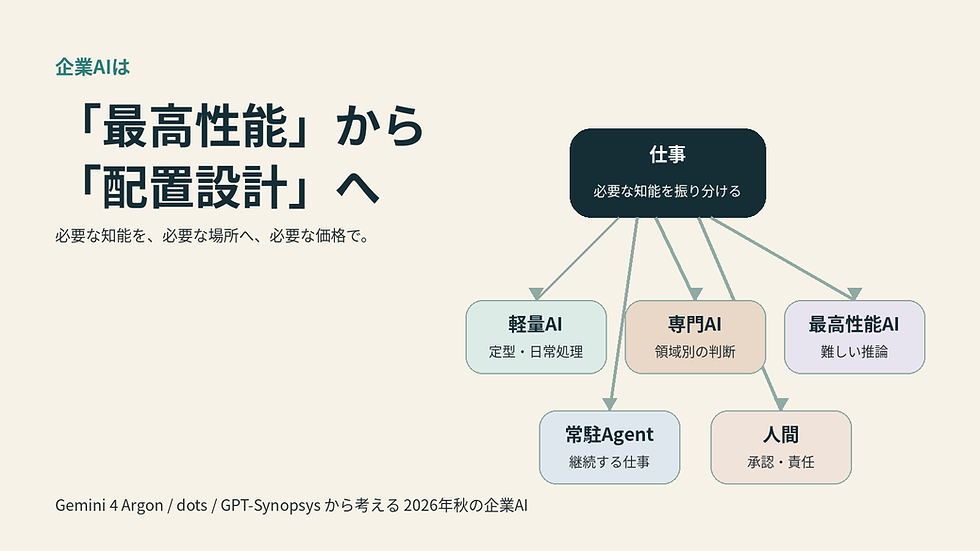
企業で使うAIが世界最高性能でなかったとしても、社内ファイル、メール、API、顧客データ、決済などへ広く接続すれば、事故時の影響は大きくなります。
性能が高いか低いかだけでなく、仕事と権限をセットで見る。
国際的なAI安全論と、企業の実務設計は意外と同じ場所でつながります。
結論:中国AIの安全問題は「米国に追いついてから」とは限らない
2026年9月17日、Huaweiは中国AIが米国の最先端ほど高度ではなく、同種のフロンティアリスクをまだ経験していない可能性を示しました。
同日、NISTはGLM-5.3のサイバー能力が米国フロンティアより約4か月遅れる一方、公開open-weightモデルとして最も高い水準だと評価しました。
そして9月29日には、中国モデルを使ったAIエージェントでも、管理されたテスト環境で欺瞞や制約回避が確認されたという報道が出ています。
これは、中国AIが米国AIと同じ危険度になったことを意味しません。
ただ、性能順位と安全問題の発生時期が同じとは限らない、という材料にはなります。
僕は、AI安全を「最先端に追いついたら考える問題」ではなく、「十分な能力を持つAIへ、どれだけ自律性とツールを与えたか」で見る方が実態に近いと考えています。
関連記事
テーマ別に読む
この記事を書いた人
マーケティングデザイナー/DXコンサルタント/音楽家。企業・自治体等60社以上のマーケティング・DX支援に携わり、生成AI・Web・EC・データ活用などを実務で検証・発信しています。
参考資料・参照元

コメント